试卷解析 · 理解每一步
2024 CCF CSP-S 第一轮(提高级 C++)
CSPS-2024-R1
试卷解析总览,可直接查看每题答案与解析。
第 1 题(单选题,2 分)
在 Linux 系统中,如果你想显示当前工作目录的路径,应该使用哪个命令?( )
A.
pwd
B.
cd
C.
ls
D.
echo
正确答案A
解析详情
思路与推导
pwd 表示 print working directory,执行后打印当前工作目录的绝对路径,例如 /home/student。
cd 用于改变当前目录,ls 用于查看目录中的内容;本题只要求显示路径,因此选 A。
第 2 题(单选题,2 分)
假设一个长度为 n 的整数数组中每个元素值互不相同,且这个数组是无序的。要找到这个数组中最大元素的时间复杂度是多少?()
A.
B.
C.
D.
正确答案A
解析详情
思路与推导
从第一个元素开始维护当前最大值,依次与剩余 n−1 个元素比较,就能找到全局最大值。
任何没被检查的元素都可能比已有最大值更大,所以无序条件下不能跳过它们。扫描上界和必须检查的下界均为线性,选 A,即 。
第 3 题(单选题,2 分)
在 C++ 中,以下哪个函数调用会造成栈溢出?( )
A.
int foo() { return 0; }
B.
int bar() { int x = 1; return x; }
C.
void baz() { int a[1000]; baz(); }
D.
void qux() { return; }
正确答案C
解析详情
思路与推导
baz 每次进入后又无条件调用自己,没有任何返回的终止条件;在通常的递归执行模型下,尚未返回的调用帧持续占用栈空间。
局部数组 a[1000] 还会增加单层调用的空间需求,递归过深最终可能耗尽栈,因此按本题模型选 C。这里不能把“任意编译优化下必然发生栈溢出”当成 C++ 的语言保证。
第 4 题(单选题,2 分)
在一场比赛中,有10名选手参加,前三名将获得金、银、铜牌。若不允许并列,且每名选手只能获得一枚奖牌,则不同的颁奖方式共有多少种?()
A.
120
B.
720
C.
504
D.
1000
正确答案B
解析详情
思路与推导
先确定金牌得主,有 10 种选择;银牌不能再选金牌得主,剩 9 种;铜牌剩 8 种。
由乘法原理,颁奖方式为 。同三人交换奖牌也属于不同方案,不能再除以 ,故选 B。
第 5 题(单选题,2 分)
下面哪个数据结构最适合实现先进先出(FIFO)的功能?
A.
栈
B.
队列
C.
线性表
D.
二叉搜索树
正确答案B
解析详情
思路与推导
队列从队尾插入、从队首删除,先进入的元素排在前面并先离开。
例如依次加入 a、b、c,再连续取出,顺序仍为 a、b、c,这就是 FIFO,选 B;栈则会按 c、b、a 取出。
第 6 题(单选题,2 分)
已知 ,且对于 有 ,则 的值为:()
A.
4
B.
5
C.
6
D.
7
正确答案B
解析详情
思路与推导
从已知 f(1)=1 向上递推,不能先求 f(4) 而忽略它依赖的较小状态。
,,因为 3/2 向下取整为 1。
最后 ,选 B。
第 7 题(单选题,2 分)
假设有一个包含 n 个顶点的无向图,且该图是欧拉图。以下关于该图的描述中哪一项不一定正确?()
A.
所有顶点的度数均为偶数
B.
该图连通
C.
该图存在一个欧拉回路
D.
该图的边数是奇数
正确答案D
解析详情
思路与推导
无向欧拉图存在经过每条边恰一次并回到起点的回路;每次进入一个顶点都要从另一条边离开,所以各顶点度数为偶数。
四个顶点首尾相连构成的四边形就是反例:它连通且各点度数为 2,存在欧拉回路,但只有 4 条边,边数为偶数。因此 D 不一定成立。
第 8 题(单选题,2 分)
对数组进行二分查找的过程中,以下哪个条件必须满足?()
A.
数组必须是有序的
B.
数组必须是无序的
C.
数组长度必须是 2 的幂
D.
数组中的元素必须是整数
正确答案A
解析详情
思路与推导
假设数组递增,目标小于中间元素时,可排除中点及其右侧;目标大于中间元素时,则可排除左侧。这个判断依赖有序性。
若数组无序,较小元素也可能藏在右侧,直接丢弃一半会漏解。因此选 A;数组长度不是 2 的幂也能正常二分。
第 9 题(单选题,2 分)
考虑一个自然数 n 以及一个模数 m,你需要计算 n 的逆元(即 n 在模 m 意义下的乘法逆元)。下列哪种算法最为适合?()
A.
使用暴力法依次尝试
B.
使用扩展欧几里得算法
C.
使用快速幂法
D.
使用线性筛法
正确答案B
解析详情
思路与推导
逆元 x 要满足 ,等价于存在整数 y 使 。
扩展欧几里得算法求出 的一组解。若最大公约数为 1,把 x 规范到 0 至 m−1 即得到逆元;否则逆元不存在。
题目未保证 m 为质数,不能直接套用费马小定理的快速幂公式,因此选 B。
第 10 题(单选题,2 分)
在设计一个哈希表时,为了减少冲突,需要使用适当的哈希函数和冲突解决策略。已知某哈希表中有 n 个键值对,表的装载因子为 ( )。在使用开放地址法解决冲突的过程中,最坏情况下查找一个元素的时间复杂度为()。
A.
B.
C.
D.
正确答案D
解析详情
思路与推导
开放地址法发生冲突后继续沿探测序列寻找。若许多键聚集到同一段,某个键可能排在 n 个已占位置的最后。
查找它需依次检查前面的冲突位置,最坏为 ,选 D。常数时间或与装载因子有关的期望估计,都依赖散列分布等条件,不能当作最坏保证。
第 11 题(单选题,2 分)
假设有一棵 h 层的完全二叉树,该树最多包含多少个结点?
A.
B.
C.
D.
正确答案A
解析详情
思路与推导
根在第 1 层,最多 1 个结点;第 2 层最多 2 个,第 i 层最多 个。
要让 h 层的结点数最多,应每层填满,等比求和得到 ,选 A。
第 12 题(单选题,2 分)
设有一个10个顶点的完全图,每两个顶点之间都有一条边。有多少个长度为4的环?()
A.
120
B.
210
C.
630
D.
5040
正确答案C
解析详情
思路与推导
一个长度为 4 的简单环使用 4 个不同顶点,先从 10 点中选出这 4 点,有 种。
固定其中一个点作书写起点,另 3 点有 种排列;顺时针和逆时针表示同一个无向环,因此每组顶点有 3 个环。
总数为 ,选 C;额外存在的弦不影响一个环是否被计入。
第 13 题(单选题,2 分)
对于一个整数 n,定义 为 n 的各位数字之和。问使 的最小自然数 x 是
多少?()
A.
29
B.
199
C.
299
D.
399
正确答案B
解析详情
思路与推导
记 s=f(x)。要求 s 的数位和为 10;满足这一点的最小非负整数是 19,因为一位数最大为 9,而 10 到 18 的数位和至多为 9。
要让 x 的数位和达到至少 19,两位数不够;三位数若要尽量小,百位取 1,剩余两位必须都取 9。
得到 x=199,且 f(199)=19、f(19)=10。比 199 小的数数位和至多为 18,均不满足,选 B。
第 14 题(单选题,2 分)
设有一个长度为 n 的 01 字符串,其中有 k 个 1,每次操作可以交换相邻两个字符。在最坏情况下将这 k 个 1 移到字符串最右边所需要的交换次数是多少?()
A.
k
B.
C.
D.
正确答案C
解析详情
思路与推导
每个“左边是 1、右边是 0”的数对都必须交换相对次序,才能把所有 1 移到最右边;一次相邻的 10→01 恰消去一个这样的逆序对。
逆序对最多在串为 11…100…0 时出现:k 个 1 中每个都跨过 n−k 个 0,共 对。
逐次交换相邻的 10 能达到该次数,因此最坏最少交换数为 ,选 C。
第 15 题(单选题,2 分)
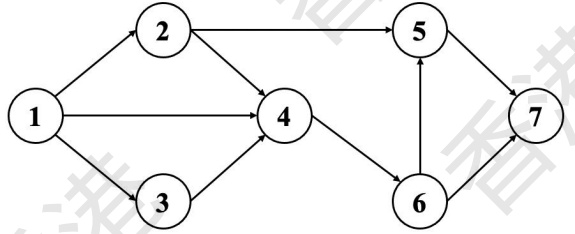
如图是一张包含7个顶点的有向图。如果要删除其中一些边,使得从节点1到节点7没有可行路径,且删除的边数最少,请问总共有多少种可行的删除边的集合?()
A.
1
B.
2
C.
3
D.
4
正确答案D
解析详情
思路与推导
图中有两条边不相交的路径:1→2→5→7 与 1→4→6→7。只删一条边不可能同时切断二者,因此至少要删 2 条。
若删 4→6,所有经过 4 的通路都被截断,还需在 1→2→5→7 上删 1→2、2→5、5→7 中的一条,得到 3 组。
若不删 4→6,要切断 1→4→6→7 就必须删 6→7 或 1→4;后者仍留有 1→3→4→6→7 等旁路,两条删边不足以同时切断上方路径。故只能删 6→7;又因 6→5→7 可绕行,还必须删 5→7。
共有 {1→2,4→6}、{2→5,4→6}、{4→6,5→7}、{5→7,6→7} 四组,选 D。
左右滑动表格,可查看完整内容。
| 组别 | 删除边一 | 删除边二 |
|---|---|---|
| 1 | 1→2 | 4→6 |
| 2 | 2→5 | 4→6 |
| 3 | 4→6 | 5→7 |
| 4 | 5→7 | 6→7 |
箭头表示原图的有向边;每组删除两条边。
二、阅读程序(1)
 1 | #include <iostream>
 2 | using namespace std;
 3 |
 4 | const int N = 1000;
 5 | int c[N];
 6 |
 7 | int logic(int x, int y) {
 8 |     return (x & y) ^ ((x ^ y) | (~x & y));
 9 | }
10 |
11 | void generate(int a, int b, int *c) {
12 |     for (int i = 0; i < b; i++) {
13 |         c[i] = logic(a, i) % (b + 1);
14 |     }
15 | }
16 |
17 | void recursion(int depth, int *arr, int size) {
18 |     if (depth <= 0 || size <= 1) return;
19 |     int pivot = arr[0];
20 |     int i = 0, j = size - 1;
21 |     while (i <= j) {
22 |         while (arr[i] < pivot) i++;
23 |         while (arr[j] > pivot) j--;
24 |         if (i <= j) {
25 |             int temp = arr[i];
26 |             arr[i] = arr[j];
27 |             arr[j] = temp;
28 |             i++; j--;
29 |         }
30 |     }
31 |     recursion(depth - 1, arr, j + 1);
32 |     recursion(depth - 1, arr + i, size - i);
33 | }
34 |
35 | int main() {
36 |     int a, b, d;
37 |     cin >> a >> b >> d;
38 |     generate(a, b, c);
39 |     recursion(d, c, b);
40 |     for (int i = 0; i < b; ++i) cout << c[i] << " ";
41 |     cout << endl;
42 | }
第 16 题(判断题,1.5 分)
当 时,输出的序列是有序的。()
正确答案正确
解析详情
思路与推导
recursion 用首元素作 pivot,双指针划分后,左侧元素不大于 pivot、右侧元素不小于 pivot,再对两侧继续递归。
每次真正递归的子区间都比原区间短,沿一条调用链至多经过 b−1 次非平凡划分就会缩到长度 1。
当 d≥b 时,深度限制不会在必要划分完成之前截断搜索,所以整个序列有序,判断正确。
第 17 题(判断题,1.5 分)
当输入"5 5 1"时,输出为"1 1 5 5 5"。()
正确答案错误
解析详情
思路与推导
logic(a,i) 等价于 a|i。a=5、b=5 时,对 6 取模生成 [5,5,1,1,5]。
d=1 只做一层划分,pivot=5。先交换下标 0 和 4,序列不变;再交换下标 1 和 3,得到 [5,1,1,5,5]。
随后左指针跳过下标 2 的 1,来到 3,超过右指针 2;两个递归调用的 depth 都为 0,立即返回。实际输出 5 1 1 5 5,判断错误。
左右滑动表格,可查看完整内容。
| 阶段 | 左指针 | 右指针 | 数组 |
|---|---|---|---|
| 初始 | 0 | 4 | 5 5 1 1 5 |
| 交换 0、4 后 | 1 | 3 | 5 5 1 1 5 |
| 交换 1、3 后 | 2 | 2 | 5 1 1 5 5 |
| 左指针跳过 1 | 3 | 2 | 5 1 1 5 5 |
下标从 0 开始;d=1 使下一层立即返回,并未整体排好序。
第 18 题(判断题,1.5 分)
假设数组 c 长度无限制,该程序所实现的算法的时间复杂度是 的。()
正确答案错误
解析详情
思路与推导
生成数组需要 ,但总开销还包括递归划分。
取 a=0,则 c[i]=i,数组严格递增;取 d≥b,每次都用当前最小值作为 pivot,只能剥离一个元素,后续区间长度依次为 b−1、b−2、… 。
划分扫描量为 ,构成非线性的合法输入族,所以判断错误。大量相等元素不必然让这里的双向划分快排退化,递增数组才是直接反例。
第 19 题(单选题,3 分)
函数 int logic(int x, int y)的功能是()
A.
按位与
B.
按位或
C.
按位异或
D.
以上都不是
正确答案B
解析详情
思路与推导
位运算可以逐位独立计算,只需列出 x、y 当前位的四种取值。
(0,0) 时结果为 0;(0,1) 时为 1;(1,0) 时为 1;(1,1) 时,外层左侧为 1、右侧为 0,结果仍为 1。
这与按位或的真值表 0、1、1、1 相同,所以整个整数运算等价于 x|y,选 B。
第 20 题(单选题,4 分)
当输入为 “10 100 100” 时,输出的第 100 个数是()
A.
91
B.
94
C.
95
D.
98
正确答案C
解析详情
思路与推导
d=100 足够把 b=100 个数排好,因此第 100 个输出就是生成数的最大值。
当 0≤i≤63 时,i|10≤63;当 64≤i≤95 时,i 的二进制权值 32 对应位为 0,10 的这一位也为 0,所以 i|10≤95,且 i=95 可以取得 95。
当 i=96、97、98、99 时,i|10 依次为 106、107、106、107,对 101 取模后仅为 5、6、5、6。
所以取模后的最大值为 95,选 C;不能误说取模前的最大值也是 95。
二、阅读程序(2)
 1 | #include <iostream>
 2 | #include <string>
 3 | using namespace std;
 4 |
 5 | const int P = 998244353, N = 1e4 + 10, M = 20;
 6 | int n, m;
 7 | string s;
 8 | int dp[1 << M];
 9 |
10 | int solve() {
11 |     dp[0] = 1;
12 |     for (int i = 0; i < n; ++i) {
13 |         for (int j = (1 << (m - 1)) - 1; j >= 0; --j) {
14 |             int k = (j << 1) | (s[i] - '0');
15 |             if (j != 0 || s[i] == '1')
16 |                 dp[k] = (dp[k] + dp[j]) % P;
17 |         }
18 |     }
19 |     int ans = 0;
20 |     for (int i = 0; i < (1 << m); ++i) {
21 |         ans = (ans + 1ll * i * dp[i]) % P;
22 |     }
23 |     return ans;
24 | }
25 |
26 | int solve2() {
27 |     int ans = 0;
28 |     for (int i = 0; i < (1<<n); ++i) {
29 |         int cnt = 0;
30 |         int num = 0;
31 |         for (int j = 0; j < n; ++j) {
32 |             if (i & (1<<j)) {
33 |                 num = num * 2 + (s[j]-'0');
34 |                 cnt++;
35 |             }
36 |         }
37 |         if (cnt <= m) (ans += num) %= P;
38 |     }
39 |     return ans;
40 | }
41 |
42 | int main() {
43 |     cin >> n >> m;
44 |     cin >> s;
45 |     if (n <= 20) {
46 |         cout << solve2() << endl;
47 |     }
48 |     cout << solve() << endl;
49 |     return 0;
50 | }
假设输入的 s 是包含 n 个字符的 01 串,完成下面的判断题和单选题:
第 21 题(判断题,1.5 分)
假设数组 dp 长度无限制,函数 solve() 所实现的算法的时间复杂度是 。()
正确答案正确
解析详情
思路与推导
外层遍历 n 个字符,内层每次遍历 个状态,判断和加法都为常数操作,转移部分为 。
结尾还扫描 个状态计算加权和,总开销为 ,所以判断正确。
第 22 题(判断题,1.5 分)
输入“11 2 10000000001”时,程序输出两个数32和23。()
正确答案正确
解析详情
思路与推导
solve2 统计所有按下标选择、长度不超过 2 的子序列数值和。单个字符贡献 2;第一个 1 与中间 9 个 0 组成 9 个“10”,贡献 18;首尾“11”贡献 3;9 个“01”贡献 9,总和 32。
solve 不允许从空状态选 0 开头,因此排除这 9 个正数值的“01”,其余贡献不变,得到 32−9=23。
两个结果确为 32 和 23。solve 仍会累计不同下标产生的相同数值,并不是在统计“本质不同子序列”。
左右滑动表格,可查看完整内容。
| 类型 | 数量 | 每个数值 | solve2 贡献 | solve 贡献 |
|---|---|---|---|---|
| 单个 1 | 2 | 1 | 2 | 2 |
| 首位 1 与中间 0 | 9 | 2 | 18 | 18 |
| 首尾两个 1 | 1 | 3 | 3 | 3 |
| 中间 0 与末位 1 | 9 | 1 | 9 | 0 |
| 合计 | 21 | — | 32 | 23 |
不同下标的选择分别计数;表中只列数值非零的子序列。
第 23 题(判断题,2 分)
在 时,solve()的返回值始终小于 。()
正确答案正确
解析详情
思路与推导
按下标选择子序列最多有 种,每个由至多 n 位组成的二进制数均小于 。
solve 只累计其中不以 0 开头、长度受 m 限制的部分,故未取模的总和严格小于 。
这个上界也小于模数 P,所以此处没有取模回绕影响,判断正确。
第 24 题(单选题,3 分)
当 n = 10 且 m = 10 时,有多少种输入使得两行的结果完全一致?()
A.
1024
B.
11
C.
10
D.
0
正确答案B
解析详情
思路与推导
m=n=10 时,长度限制不起作用。两函数的差只来自 solve2 额外计入的、以 0 开头的子序列。
若存在一个 0 在某个 1 之前,可选它们组成“01”,给 solve2 增加正贡献;这里总和未超过模数,因此不可能被取模抹平。
若所有 1 都在所有 0 之前,额外的前导零子序列只包含 0,贡献均为 0,两函数相等。
因此串必须是若干个 1 后接若干个 0,1 的数量可以从 0 到 10,共 11 种,选 B。
第 25 题(单选题,3 分)
当 n <= 6 时,solve() 的最大可能返回值为()
A.
65
B.
211
C.
665
D.
2059
正确答案C
解析详情
思路与推导
要最大化总和,应取 n=6、m≥6,并把每一位设为 1;把 0 改成 1 只会提高对应子序列的值,还可能使原先被禁止的前导零子序列变为合法。
长度为 r 的子序列共有 个,每个值为 。
总和为 ,选 C。r=0 项为 0,不影响求和。
第 26 题(单选题,3 分)
若 n = 8, m = 8, solve 和 solve2 的返回值的最大可能的差值为()
A.
1477
B.
1995
C.
2059
D.
2187
正确答案C
解析详情
思路与推导
m=n=8 时可枚举全部 256 个二进制串,用递推逐位计算两种总和,避免列举每条子序列。
令 A 为所有子序列数值和、C 为其数量(含空串),B 为非零开头子序列数值和、D 为其数量。初值 A=B=D=0、C=1。读入位 v 时,同时更新 A′=3A+vC、C′=2C,B′=3B+vD+v、D′=2D+v。
枚举八次的 0/1 分支比较 A−B,最大为 2059,在 01111111 取得。后七个 1 的有效子序列和为 ;开头 0 选或不选让 solve2 加倍为 4118,而 solve 为 2059。
故差值最大为 2059,选 C。
二、阅读程序(3)
 1 | #include <iostream>
 2 |
 3 | #include <cstring>
 4 |
 5 | #include <algorithm>
 6 |
 7 | using namespace std;
 8 |
 9 | const int maxn = 1000000 + 5;
10 |
11 | const int P1 = 998244353, P2 = 1000000007;
12 |
13 | const int B1 = 2, B2 = 31;
14 |
15 | const int K1 = 0, K2 = 13;
16 |
17 | typedef long long ll;
18 |
19 | int n;
20 | bool p[maxn];
21 | int p1[maxn], p2[maxn];
22 |
23 | struct H {
24 |     int h1, h2, l;
25 |     H(bool b = false) {
26 |         h1 = b + K1;
27 |         h2 = b + K2;
28 |         l = 1;
29 |     }
30 |     H operator + (const H & h) const {
31 |         H hh;
32 |         hh.l = l + h.l;
33 |         hh.h1 = (1ll * h1 * p1[h.l] + h.h1) % P1;
34 |         hh.h2 = (1ll * h2 * p2[h.l] + h.h2) % P2;
35 |         return hh;
36 |     }
37 |     bool operator == (const H & h) const {
38 |         return l == h.l && h1 == h.h1 && h2 == h.h2;
39 |     }
40 |     bool operator < (const H & h) const {
41 |         if (l != h.l) return l < h.l;
42 |         else if (h1 != h.h1) return h1 < h.h1;
43 |         else return h2 < h.h2;
44 |     }
45 | }
46 | h[maxn];
47 |
48 | void init() {
49 |     memset(p, 1, sizeof(p));
50 |     p[0] = p[1] = false;
51 |     p1[0] = p2[0] = 1;
52 |     for (int i = 1; i <= n; ++i) {
53 |         p1[i] = (1ll * B1 * p1[i-1]) % P1;
54 |         p2[i] = (1ll * B2 * p2[i-1]) % P2;
55 |         if (!p[i]) continue;
56 |         for (int j = 2 * i; j <= n; j += i) {
57 |             p[j] = false;
58 |         }
59 |     }
60 | }
61 |
62 | int solve() {
63 |     for (int i = n; i; --i) {
64 |         h[i] = H(p[i]);
65 |         if (2 * i + 1 <= n) {
66 |             h[i] = h[2 * i] + h[i] + h[2 * i + 1];
67 |         } else if (2 * i <= n) {
68 |             h[i] = h[2 * i] + h[i];
69 |         }
70 |     }
71 |     cout << h[1].h1 << endl;
72 |     sort(h + 1, h + n + 1);
73 |     int m = unique(h + 1, h + n + 1) - (h + 1);
74 |     return m;
75 | }
76 |
77 | int main() {
78 |     cin >> n;
79 |     init();
80 |     cout << solve() << endl;
81 | }
第 27 题(判断题,1.5 分)
假设程序运行前能自动将 maxn 改为 n+1,所实现的算法的时间复杂度是 。()
正确答案正确
解析详情
思路与推导
init 预处理底数幂并筛出质数。幂数组为线性处理,筛法总工作量为 。
solve 自底向上把每个结点的哈希合并一次,共 ;随后对 n 个固定大小的三元组排序,需 ,unique 再线性扫描。
数组按 n 配置时,总体由排序主导,为 ,判断正确。
第 28 题(判断题,1.5 分)
时间开销的瓶颈是 init()函数。()
正确答案错误
解析详情
思路与推导
init 的倍数标记只在质数 i 上执行,不能简单按“有两层循环”认定为平方复杂度;它是筛法量级。
solve 中的排序需 ,比筛法的 增长更快,因此按渐近复杂度分析,瓶颈在 solve 的排序,题述错误。
第 29 题(判断题,1.5 分)
若修改常数 B1 或 K1 的值,该程序可能会输出不同的结果。()
单选题
正确答案正确
解析详情
思路与推导
第一行直接打印根的第一组哈希,所以只要编码参数变化,就可能在去重之前改变输出。
例如 n=1 时,编号 1 不是质数,H(false) 的 h1=K1。把 K1 从 0 改为 1,第一行就由 0 变为 1。
这一具体反例已经足以证明“可能输出不同结果”为真,不需要依赖是否发生哈希碰撞。
第 30 题(单选题,3 分)
在 solve() 函数中,h[] 的合并顺序可以看作是:()
A.
二叉树的 BFS 序
B.
二叉树的先序遍历
C.
二叉树的中序遍历
D.
二叉树的后序遍历
正确答案C
解析详情
思路与推导
数组编号中 2i 是左孩子、2i+1 是右孩子。合并式先放 h[2i],再放当前 h[i],最后放 h[2i+1]。
这正是“左子树、根、右子树”的中序遍历,选 C。倒序循环 i=n…1 只是确保孩子哈希先算好,不代表拼接的是后序。
第 31 题(单选题,3 分)
输入“10”,输出的第一行是?()
A.
83
B.
424
C.
54
D.
110101000
正确答案A
解析详情
思路与推导
n=10 时,按左、根、右得到结点编号 8,4,9,2,10,5,1,6,3,7。
其中质数为 2、3、5、7,依编号序列逐项写出真假,得到 0001010011。
B1=2、K1=0,使第一组哈希等价于这个二进制串的值:,未达到模数,选 A。
第 32 题(单选题,4 分)
输入“16”,输出的第二行是?()
A.
7
B.
9
C.
10
D.
12
正确答案C
解析详情
思路与推导
每个 h[i] 表示以 i 为根的子树中序质数标记串,并保存长度与两组哈希。求第二行输出时,要比较整棵子树的串,而非仅看当前结点。
编号 9 至 16 的叶子产生“0”和“1”两类;结点 8 产生“00”;结点 4、5、6、7 分别产生“0000”、“011”、“001”、“010”,四串互不相同。
结点 3、2、1 的串分别为“0011010”、“00001011”、“0000101100011010”,长度分别为 7、8、16,又各自独立。
这十种串的实际长度及双哈希也互不相同,因此 unique 得到 10 类,选 C。
左右滑动表格,可查看完整内容。
| 子树根编号 | 中序编码 | 长度 |
|---|---|---|
| 9、10、12、14、15、16 | 0 | 1 |
| 11、13 | 1 | 1 |
| 8 | 00 | 2 |
| 4 | 0000 | 4 |
| 5 | 011 | 3 |
| 6 | 001 | 3 |
| 7 | 010 | 3 |
| 3 | 0011010 | 7 |
| 2 | 00001011 | 8 |
| 1 | 0000101100011010 | 16 |
0 表示非质数编号,1 表示质数编号;每串按子树中序遍历生成。
三、完善程序(1)
(1)(序列合并)有两个长度为 N 的单调不降序列 A 和 B,序列的每个元素都是小于 10^9 的非负整数。在 A 和 B 中各取一个数相加可以得到 N^2 个和,求其中第 K 小的和。上述参数满足 N <= 10^5 和 1 <= K <= N^2。
#include <iostream>
using namespace std;

const int maxn = 100005;

int n;
long long k;
int a[maxn], b[maxn];

int* upper_bound(int *a, int *an, int ai) {
    int l = 0, r = ①;
    while (l < r) {
        int mid = (l + r) >> 1;
        if (②) {
            r = mid;
        } else {
            l = mid + 1;
        }
    }
    return ③;
}

long long get_rank(int sum) {
    long long rank = 0;
    for (int i = 0; i < n; ++i) {
        rank += upper_bound(b, b + n, sum - a[i]) - b;
    }
    return rank;
}

int solve() {
    int l = 0, r = ④;
    while (l < r) {
        int mid = ((long long)l + r) >> 1;
        if (⑤) {
            l = mid + 1;
        } else {
            r = mid;
        }
    }
    return l;
}

int main() {
    cin >> n >> k;
    for (int i = 0; i < n; ++i) cin >> a[i];
    for (int i = 0; i < n; ++i) cin >> b[i];
    cout << solve() << endl;
}
第 33 题(单选题,3 分)
①处应填
A.
an-aB.
an-a-1C.
aiD.
ai+1正确答案A
解析详情
思路与推导
upper_bound 在长度 an−a 的有序区间中,寻找第一个严格大于 ai 的位置。答案可能位于所有元素之后,因此合法返回下标范围为 0 到 an−a。
二分初始 l=0、r=an−a,mid 始终落在可访问元素范围内;若全部元素≤ai,最终 l=r=an−a,返回尾后指针。因此①选 A。
第 34 题(单选题,3 分)
②处应填
A.
a[mid] > aiB.
a[mid] >= aiC.
a[mid] < aiD.
a[mid] <= ai正确答案A
解析详情
思路与推导
希望找到第一个 a[mid]>ai 的位置。若当前元素已经严格大于 ai,答案可能是 mid 或更靠左的位置,所以执行 r=mid。
否则当前元素≤ai,不是所求位置,并可排除左侧,执行 l=mid+1。因此②填 a[mid]>ai,选 A。
例如 [1,2,2,4] 查阈值 2,要返回 4 的位置,才能统计出前面 3 个≤2 的元素。
第 35 题(单选题,3 分)
③处应填
A.
a+lB.
a+l+1C.
a+l-1D.
an-l正确答案A
解析详情
思路与推导
循环结束时 l=r,是第一个大于 ai 的元素下标,或尾后下标。函数返回类型为 int*,要返回基址 a 加下标 l。
调用处 upper_bound(b,b+n,阈值)−b 再把指针差转为元素个数,因此③选 a+l,即 A;不需要额外加减 1。
第 36 题(单选题,3 分)
④处应填
A.
a[n-1]+b[n-1]B.
a[n]+b[n]C.
D.
maxn正确答案A
解析详情
思路与推导
两数组均递增,所有数对和的上界就是各自最大元素之和 a[n−1]+b[n−1]。
在这个阈值下,get_rank 至少覆盖全部 个数对,必然不小于合法的 k;下界 0 也不高于任何非负数对和。
因此④选 A。元素小于 ,该上界仍落在通常的 32 位 int 范围内,求中点时程序另用 long long 防止 l+r 溢出。
第 37 题(单选题,3 分)
⑤处应填
A.
get_rank(mid) < kB.
get_rank(mid) <= kC.
get_rank(mid) > kD.
get_rank(mid) >= k正确答案A
解析详情
思路与推导
固定 a[i] 后,b[j]≤mid−a[i] 恰等价于 a[i]+b[j]≤mid,upper_bound 的指针差统计这样的 j 数量,累加得到 get_rank(mid)。
第 k 小的值是第一个使计数≥k 的阈值。如果 get_rank(mid)<k,mid 太小,答案在右侧,需 l=mid+1。
其余情况保留 mid 并令 r=mid,因此⑤选 A。重复的和按不同数对分别计数。
三、完善程序(2)
(2)(次短路)已知一个有 n 个点 m 条边的有向图 G,并且给定图中的两个点 s 和 t,求次短路(长度严格大于最短路的最短路径)。如果不存在,输出一行“-1”。如果存在,输出两行,第一行表示次短路的长度,第二行表示次短路的一个方案。
#include <cstdio>
#include <queue>
#include <utility>
#include <cstring>
using namespace std;

const int maxn = 2e5 + 10, maxm = 1e6 + 10, inf = 522133279;

int n, m, s, t;
int head[maxn], nxt[maxm], to[maxm], w[maxm], tot = 1;
int dis[maxn << 1], *dis2;
int pre[maxn << 1], *pre2;
bool vis[maxn << 1];

void add(int a, int b, int c) {
    ++tot;
    nxt[tot] = head[a];
    to[tot] = b;
    w[tot] = c;
    head[a] = tot;
}

bool upd(int a, int b, int d, priority_queue<pair<int, int>> &q) {
    if (d >= dis[b]) return false;
    if (b < n)
        ①;
    q.push(②);
    dis[b] = d;
    pre[b] = a;
    return true;
}

void solve() {
    priority_queue<pair<int, int>> q;
    q.push(make_pair(0, s));
    memset(dis, ③, sizeof(dis));
    memset(pre, -1, sizeof(pre));
    dis2 = dis + n;
    pre2 = pre + n;

    dis[s] = 0;
    while (!q.empty()) {
        int aa = q.top().second; q.pop();
        if (vis[aa]) continue;
        vis[aa] = true;
        int a = aa % n;
        for (int e = head[a]; e; e = nxt[e]) {
            int b = to[e], c = w[e];
            if (aa < n) {
                if (!upd(a, b, dis[a]+c, q))
                    ④;
            } else {
                upd(n+a, n+b, dis2[a]+c, q);
            }
        }
    }
}

void out(int a) {
    if (a != s) {
        if (a < n) out(pre[a]);
        else out(⑤);
    }
    printf("%d%c", a%n+1, " \n"[a == n+t]);
}

int main() {
    scanf("%d%d%d%d", &n, &m, &s, &t);
    s--, t--;
    for (int i = 0; i < m; ++i) {
        int a, b, c;
        scanf("%d%d%d", &a, &b, &c);
        add(a-1, b-1, c);
    }
    solve();
    if (dis2[t] == inf) puts("-1");
    else {
        printf("%d\n", dis2[t]);
        out(n+t);
    }
}
第 38 题(单选题,3 分)
①处应填()
A.
upd(pre[b], n+b, dis[b], q)B.
upd(a, n+b, d, q)C.
upd(pre[b], b, dis[b], q)D.
upd(a, b, d, q)正确答案A
解析详情
思路与推导
状态 b 保存到顶点 b 的最短距离,状态 n+b 保存第二候选距离。当新距离 d 更小时,原 dis[b] 仍是一条有效路径,必须在覆盖前转存到第二层。
旧路径的前驱是 pre[b],不是这条新路径的前驱 a,因此①填 upd(pre[b],n+b,dis[b],q),选 A。
这解释了旧最短路转存的作用;原程序对等长候选的处理还存在严格次短路边界问题,见第 41 题说明。
第 39 题(单选题,3 分)
②处应填()
A.
make_pair(-d, b)B.
make_pair(d, b)C.
make_pair(b, d)D.
make_pair(-b, d)正确答案A
解析详情
思路与推导
priority_queue<pair<int,int>> 默认优先取 first 最大的元素,而 Dijkstra 需要优先取距离最小的状态。
将距离 d 取负后,较小距离有更大的 −d;把状态编号 b 放在 second,弹出后即可知道扩展哪个状态。因此②选 make_pair(−d,b),即 A。
例如距离 3 和 8 对应 −3 与 −8,前者优先出队。
第 40 题(单选题,3 分)
③处应填()
A.
0xffB.
0x1fC.
0x3fD.
0x7f正确答案B
解析详情
思路与推导
memset 按字节填充,不是给每个 int 直接赋参数值。通常四字节 int 填入 0x1f 后,位型为 0x1f1f1f1f。
其值为 ,恰好等于程序 inf,所以③选 B。
必须匹配该常量,最后 dis2[t]==inf 才能正确识别未到达状态。
第 41 题(单选题,3 分)
④处应填()
A.
upd(a, n+b, dis[a]+c, q)B.
upd(n+a, n+b, dis2[a]+c, q)C.
upd(n+a, b, dis2[a]+c, q)D.
upd(a, b, dis[a]+c, q)正确答案A
解析详情
思路与推导
按填空的局部状态含义,从最短状态 a 沿边到 b 的候选距离为 dis[a]+c;未更新最短距离时,会尝试把这一候选写入第二层 n+b,故给定答案为 A。
但原卷称“严格次短路”,此代码缺少排除等长候选的判断。若存在两条长度均为 2 的 s→t 路径,它会把另一条长度 2 的路径记入第二层,即使根本不存在更长路径。
例如边为 1→2(1)、1→3(1)、2→4(1)、3→4(1),s=1、t=4;严格次短路应不存在,按 A 补全却输出 2。这里保留原题答案,同时明确:该选项吻合代码结构,不构成严格次短路正确性的证明。
第 42 题(单选题,3 分)
⑤处应填()
A.
pre2[a%n]B.
pre[a%n]C.
pre2[a]D.
pre[a%n]+1正确答案A
解析详情
思路与推导
第二层状态 a≥n 代表原顶点 a%n。pre2 已指向 pre+n,因此 pre2[a%n] 就是这个第二层状态保存的前驱编号。
这个前驱可能属于第一层,也可能属于第二层,递归函数会根据编号自动继续选择相应数组,所以⑤选 A。
不能再以 a 为 pre2 的下标,否则会重复加一次层偏移。