试卷解析 · 理解每一步
2023 CCF CSP-S 第一轮(提高级 C++)
CSPS-2023-R1
试卷解析总览,可直接查看每题答案与解析。
第 1 题(单选题,2 分)
在 Linux 系统终端中,以下哪个命令用于创建一个新的目录?()
A.
newdir
B.
mkdir
C.
create
D.
mkfolder
正确答案B
解析详情
思路与推导
mkdir 是 make directory 的缩写,用于创建目录。例如 mkdir work 会在当前目录下创建名为 work 的子目录。
题目给出的标准命令是 B;是否创建成功还取决于目标名称、目录权限等,但不影响这里的命令识别。
第 2 题(单选题,2 分)
0, 1, 2, 3, 4 中选取 4 个数字,能组成()个不同四位数。(注:最小的四位数是 1000,最大的四位数是 9999。)
A.
96
B.
18
C.
120
D.
84
正确答案A
解析详情
思路与推导
千位不能为 0,可从 1、2、3、4 中选择,共 4 种。
选定千位后,余下 4 个数字中依次选百位、十位、个位,有 种。
总数为 ,选 A。数字 0 可以出现在后三位,只是不能作最高位。
第 3 题(单选题,2 分)
假设 n 是图的顶点的个数,m 是图的边的个数,为求解某一问题有下面四种不同时间复杂度的算法。对于 的稀疏图而言,下面的四个选项,哪一项的渐近时间复杂度最小。
( )
A.
B.
C.
D.
正确答案A
解析详情
思路与推导
先代入稀疏条件 m 与 n 同阶。A 为 ,D 为 ;B、C 的主项分别是平方级和平方除以对数,均更大。
比较 A 与 D,前者除以后者的增长项得到 ,随 n 增大趋向 0。
因此 A 增长最慢,不能因其式子较复杂而误判更慢。
第 4 题(单选题,2 分)
假设有 n 根柱子,需要按照以下规则依次放置编号为 1、2、3、… 的圆环:每根柱子的底部固定,顶部可以放入圆环;每次从柱子顶部放入圆环时,需要保证任何两个相邻圆环的编号之和是一个完全平方数。请计算当有 4 根柱子时,最多可以放置( )个圆环。
A.
7
B.
9
C.
11
D.
5
正确答案C
解析详情
思路与推导
可按由底到顶放成四列:[1,3,6,10]、[2,7,9]、[4,5,11]、[8],相邻和分别是 4、9、16 等完全平方数,所以 1 至 11 可放下。
再证明 12 不可能放下:1、2、4 都找不到更小的正整数与自己配成完全平方数,因此至少需要三根柱子作起点。3 和 8 都只有前驱 1,但同一个球上面只能直接放一个球,所以二者至少有一个必须另开一柱。
同理,5 和 12 都只有前驱 4,二者也至少有一个必须另开一柱。两组涉及不同球,因此至少需要 3+1+1=5 根柱子,超过四根的限制。
所以任何方案都无法放到 12,上限为 11,选 C。
左右滑动表格,可查看完整内容。
| 柱子 | 球的编号 | 相邻和 |
|---|---|---|
| 第 1 根 | 1 → 3 → 6 → 10 | 4、9、16 |
| 第 2 根 | 2 → 7 → 9 | 9、16 |
| 第 3 根 | 4 → 5 → 11 | 9、16 |
| 第 4 根 | 8 | 无相邻球 |
每列从底到顶;同一列相邻编号之和均为完全平方数。
第 5 题(单选题,2 分)
以下对数据结构的表述不恰当的一项是:()。
A.
队列是一种先进先出(FIFO)的线性结构
B.
哈夫曼树的构造过程主要是为了实现图的深度优先搜索
C.
散列表是一种通过散列函数将关键字映射到存储位置的数据结构
D.
二叉树是一种每个结点最多有两个子结点的树结构
正确答案B
解析详情
思路与推导
哈夫曼树把较小权值反复合并,目的是使带权路径长度最小,常用于构造可变长前缀编码。
图的深度优先搜索则沿未访问顶点不断深入,通过递归或栈回溯,与“选择两个最小权值合并”的过程不同。因此 B 的用途描述不恰当。
第 6 题(单选题,2 分)
以下连通无向图中,()一定可以用不超过两种颜色进行染色。
A.
完全三叉树
B.
平面图
C.
边双连通图
D.
欧拉图
正确答案A
解析详情
思路与推导
把树的根染成颜色 1,深度为偶数和奇数的结点交替染两种颜色。树的每条边只连接父子,深度相差 1,所以不会冲突。
完全三叉树也属于树,必能两色染色,选 A。三角形同时是平面图、边双连通图和欧拉图,却有奇环,必须三色,能排除其余类别的必然性。
第 7 题(单选题,2 分)
最长公共子序列长度常常用来衡量两个序列的相似度。其定义如下:给定两个序列 和 ,最长公共子序列(LCS)问题的目标是找到一个最长的新序列 ,使得序列 既是序列 的子序列,又是序列 的子序列,且序列 的长度 在满足上述条件的序列里是最大的。(注:序列 是序列 的子序列,当且仅当在保持序列 元素顺序的情况下,从序列 中删除若干个元素,可以使得剩余的元素构成序列 。)则序列 “ABCAAAABA” 和 “ABABCBABA” 的最长公共子序列长度为( )。
A.
4
B.
5
C.
6
D.
7
正确答案C
解析详情
思路与推导
设 dp[i][j] 为前 i、j 个字符的 LCS 长度。末字符相同可用 dp[i−1][j−1]+1,否则取 dp[i−1][j] 与 dp[i][j−1] 的较大者。
对 X=ABCAAAABA 逐行计算,最终对 Y 各前缀的结果为 1,2,3,4,4,4,5,5,6,所以完整长度为 6。
例如 ABCABA 在 X 中可选位置 1,2,3,4,8,9,在 Y 中可选 1,2,5,7,8,9。它给出长度 6 的构造,而 DP 证明不能达到 7,选 C。
左右滑动表格,可查看完整内容。
| Y 的前缀长度 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|---|
| LCS 长度 | 0 | 1 | 2 | 3 | 4 | 4 | 4 | 5 | 5 | 6 |
X 固定为 ABCAAAABA;依次增加 Y 的前缀,数值由完整 DP 递推得到。
第 8 题(单选题,2 分)
一位玩家正在玩一个特殊的掷骰子的游戏,游戏要求连续掷两次骰子,收益规则如下:玩家第一次掷出 x 点,得到 2x 元;第二次掷出 y 点,当 y=x 时玩家会失去之前得到的 2x 元,而当 y≠x 时玩家能保住第一次获得的 2x 元。上述 x, y∈{1,2,3,4,5,6}。例如:玩家第一次掷出 3 点得到 6 元后,但第二次再次掷出 3 点,会失去之前得到的 6 元,玩家最终收
益为0元;如果玩家第一次掷出3点、第二次掷出4点,则最终收益是6元。假设骰子掷出任意一点的概率均为1/6,玩家连续掷两次骰子后,所有可能情形下收益的平均值是多少?()
A.
7 元
B.
元
C.
元
D.
元
正确答案B
解析详情
思路与推导
固定第一次点数 x。第二次只有一个点数会让收益清零,其余五个点数均保留 2x,因此条件期望为 。
第一次的六种 x 等可能,平均点数为 。
总体期望为 元,选 B。
第 9 题(单选题,2 分)
假设我们有以下的 C++ 代码:
int a = 5, b = 3, c = 4;
bool res = a & b || c ^ b && a | c;
请问,res 的值是什么?()
提示:在 C++ 中,逻辑运算的优先级从高到低依次为:逻辑非(!)、逻辑与(&&)、逻辑或(||)。位运算的优先级从高到低依次为:位非(~)、位与(&)、位异或(^)、位或(|)。同时,双目位运算的优先级高于双目逻辑运算;逻辑非和位非优先级相同,且高于所有双目运算符。
A.
true
B.
false
C.
1
D.
0
正确答案A
解析详情
思路与推导
按优先级加括号,表达式为 (a&b) || ((c^b)&&(a|c))。
先算 5&3=1,左侧已经为真,|| 发生短路,右侧实际上无需执行,res 得到布尔值 true,选 A。
若仅作数值核对,右侧的位运算分别会得到 7 和 5,也都为真;但不能据此说实际程序一定求值了右侧。bool 的默认流输出可显示 1,本题按布尔字面值选择 true。
第 10 题(单选题,2 分)
假设快速排序算法的输入是一个长度为 n 的已排序数组,且该快速排序算法在分治过程总是选择第一个元素作为基准元素。以下哪个选项描述的是在这种情况下快速排序行为?
( )
A.
快速排序对于此类输入的表现最好,因为数组已经排序。
B.
快速排序对于此类输入的时间复杂度是 。
C.
快速排序对于此类输入的时间复杂度是 。
D.
快速排序无法对此类数组进行排序,因为数组已经排序。
正确答案C
解析详情
思路与推导
已排序且元素按通常不同值情形分析时,首元素是最小值或最大值。每次以它为基准,剩余非空子问题只有一个,规模为 n−1。
划分的总工作量为 ,选 C。
只有划分近似平衡时才能得到通常的对数层数,本题没有随机选枢轴来避免退化。
第 11 题(单选题,2 分)
以下哪个命令,能将一个名为 “main.cpp” 的 C++源文件,编译并生成一个名为 “main” 的可执行文件?()
A.
g++ -o main main.cpp
B.
g++ -o main.cpp main
C.
g++ main -o main.cpp
D.
g++ main.cpp -o main.cpp
正确答案A
解析详情
思路与推导
g++ 后的 main.cpp 是输入源文件;-o 后紧随的 main 是输出文件名。参数 -o 可以放在源文件之前,只要它的参数对应正确即可。
因此 g++ -o main main.cpp 会生成名为 main 的可执行文件,选 A。把 main.cpp 放在 -o 后会错误地指定输出名。
第 12 题(单选题,2 分)
在图论中,树的重心是树上的一个结点,以该结点为根时,使得其所有的子树中结点数最多的子树的结点数最少。一棵树可能有多个重心。请问下面哪种树一定只有一个重心?( )。
A.
4 个结点的树
B.
6 个结点的树
C.
7 个结点的树
D.
8 个结点的树
正确答案C
解析详情
思路与推导
树最多有两个重心;若有两个,它们相邻,删去连接边会把树分成大小相同的两半。
相同大小的两半要求总结点数为偶数,因此 7 个结点不可能有两个重心,必然唯一,选 C。
偶数结点不一定有两个,但偶数长度的链就有两个,足以否定其他选项中的“一定唯一”。
第 13 题(单选题,2 分)
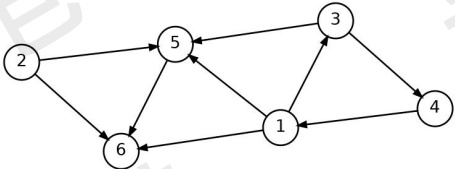
如图是一张包含 6 个顶点的有向图,但顶点间不存在拓扑序。如果要删除其中一条边,使这 6 个顶点能进行拓扑排序,请问总共有多少条边可以作为候选的被删除边?()
A.
1
B.
2
C.
3
D.
4
正确答案C
解析详情
思路与推导
观察箭头,唯一有向环为 1→3→4→1;结点 2 只向外连接,5、6 方向形成向 6 汇入的支路,不会构成另一个回路。
删除 1→3、3→4、4→1 中任意一条,都能打破该环,使全图变成 DAG;删除环外边则仍保留这个环。
因此候选边恰有 3 条,选 C。
第 14 题(单选题,2 分)
若 ,定义 ;其中 。对于给定自然数 ,存在序列 ,其中对于 都有 ,且 ,称 为 关于 的不动点。问在 至 中,关于 的不动点为 9 的自然数个数为( )。
A.
B.
11
C.
12
D.
13
正确答案B
解析详情
思路与推导
十六进制中 ,所以每次求数位和都保持模 15 的余数;反复求和最终得到 0 至 15 的一位数。
对正数而言,不动点为 9 等价于原数模 15 余 9。区间端点按题意为 与 。
区间内最小符合数为 264,最大为 414,相邻间隔 15,共 个,选 B。
第 15 题(单选题,2 分)
现在用如下代码来计算 ,其时间复杂度为()。
double quick_power(double x, unsigned n) {
    if (n == 0) return 1;
    if (n == 1) return x;
    return quick_power(x, n / 2)
    * quick_power(x, n / 2)
    * ((n & 1) ? x : 1);
}A.
B.
C.
D.
正确答案A
解析详情
思路与推导
虽然每个递归参数都减半,但相同的 quick_power(x,n/2) 被调用两次,没有保存第一次的结果。
调用树每层结点数约翻倍,深度约为 ,总调用数为 ,选 A。
标准快速幂只计算一次半幂并复用,才会得到 。
二、阅读程序(1)
 1 | #include <iostream>
 2 | using namespace std;
 3 |
 4 | unsigned short f(unsigned short x) {
 5 |     x ^= x << 6;
 6 |     x ^= x >> 8;
 7 |     return x;
 8 | }
 9 |
10 | int main() {
11 |     unsigned short x;
12 |     cin >> x;
13 |     unsigned short y = f(x);
14 |     cout << y << endl;
15 |     return 0;
16 | }
假设输入的 x 是不超过 65535 的自然数,完成下面的判断题和单选题:
第 16 题(判断题,1.5 分)
当输入非零时,输出一定不为零。()
正确答案正确
解析详情
思路与推导
按题目采用的 16 位 unsigned short 模型,设 x 最低的非零位在第 t 位。x<<6 在第 t 位仍为 0,因此第一步异或后第 t 位仍为 1,截断高位也不会消去它。
再对第一步结果取最高的非零位,第 8 位右移后的值在这个位置必为 0,所以第二步异或也不能清空最高非零位。
两步都把非零数映射为非零数,因此判断正确。
第 17 题(判断题,2 分)
将 f 函数的输入参数的类型改为 unsigned int,程序的输出不变。()
正确答案错误
解析详情
思路与推导
unsigned short 变量在每次复合赋值后按 16 位保存;换成 unsigned int,会保留第一步产生的更高位,这些位能在下一次右移时回到低 16 位。
取 x=1024:原程序第一步把 1024 xor 65536 截成 1024,第二步得到 1028。改为 unsigned int 参数后,第一步保留 66560,第二步为 66820,返回 unsigned short 时截成 1284。
1028 与 1284 不同,所以判断错误;截断发生在赋值/返回转换处,不是移位表达式本身自动使用 16 位运算。
第 18 题(判断题,1.5 分)
当输入为 “65535” 时,输出为 “63”。()
正确答案正确
解析详情
思路与推导
65535 的低 16 位全为 1,左移 6 位后低 16 位为 1111111111000000。
两者异或再存回 unsigned short,只剩低 6 位为 1,即 63。63>>8=0,第二步异或不改变它。
因此输出 63,判断正确。
第 19 题(判断题,1.5 分)
当输入为 “1” 时,输出为 “64”。()
正确答案错误
解析详情
思路与推导
第一步为 1 xor (1<<6)=1 xor 64=65,保留了原来的最低位 1。
因为 65<256,右移 8 位为 0,第二步仍为 65。因此输出 65,不是 64,判断错误。
第 20 题(单选题,3 分)
当输入为 “512” 时,输出为()。
A.
“33280”
B.
“33410”
C.
“33106”
D.
“33346”
正确答案B
解析详情
思路与推导
512 为 ,左移 6 位成为 ,与原值没有重合的 1 位,异或结果为 33280。
再把 33280 右移 8 位得到 130;它与 33280 的 1 位也不重合,最终为 33280+130=33410,选 B。
第 21 题(单选题,3 分)
当输入为 “64” 时,执行完第 5 行后 x 的值为()。
A.
“8256”
B.
“4130”
C.
“4128”
D.
“4160”
正确答案D
解析详情
思路与推导
题目只问执行第 5 行后,还没有执行右移异或。
64<<6=4096,两者分别只有第 6、12 位为 1,异或得到 4096+64=4160,选 D。
二、阅读程序(2)
 1 | #include <iostream>
 2 | #include <cmath>
 3 | #include <vector>
 4 | #include <algorithm>
 5 | using namespace std;
 6 |
 7 | long long solve1(int n) {
 8 |     vector<bool> p(n+1, true);
 9 |     vector<long long> f(n+1, 0), g(n+1, 0);
10 |     f[1] = 1;
11 |     for (int i = 2; i * i <= n; i++) {
12 |         if (p[i]) {
13 |             vector<int> d;
14 |             for (int k = i; k <= n; k *= i) d.push_back(k);
15 |             reverse(d.begin(), d.end());
16 |             for (int k : d) {
17 |                 for (int j = k; j <= n; j += k) {
18 |                     if (p[j]) {
19 |                         p[j] = false;
20 |                         f[j] = i;
21 |                         g[j] = k;
22 |                     }
23 |                 }
24 |             }
25 |         }
26 |     }
27 |     for (int i = sqrt(n) + 1; i <= n; i++) {
28 |         if (p[i]) {
29 |             f[i] = i;
30 |             g[i] = i;
31 |         }
32 |     }
33 |     long long sum = 1;
34 |     for (int i = 2; i <= n; i++) {
35 |         f[i] = f[i / g[i]] * (g[i] * f[i] - 1) / (f[i] - 1);
36 |         sum += f[i];
37 |     }
38 |     return sum;
39 | }
40 |
41 | long long solve2(int n) {
42 |     long long sum = 0;
43 |     for (int i = 1; i <= n; i++) {
44 |         sum += i * (n / i);
45 |     }
46 |     return sum;
47 | }
48 |
49 | int main() {
50 |     int n;
51 |     cin >> n;
52 |     cout << solve1(n) << endl;
53 |     cout << solve2(n) << endl;
54 |     return 0;
55 | }
假设输入的 n 是不超过 1000000 的自然数,完成下面的判断题和单选题:
第 22 题(判断题,1.5 分)
将第 15 行删去,输出不变。()
正确答案错误
解析详情
思路与推导
d 保存某个质数 i 的各次幂,倒序遍历让一个数先遇到它能整除的最大 i 的幂,之后 p[j] 被置 false,不再被较小幂覆盖。
取 n=4:正常顺序先处理 4,得到 g[4]=4,最后 f[4]=7;若不 reverse,先处理 2 就把 g[4] 固定为 2,随后算得 f[4]=f[2]×3=9。
于是第一行由 15 变为 17,输出改变,判断错误。
第 23 题(判断题,1.5 分)
当输入为 “10” 时,输出的第一行大于第二行。()
正确答案错误
解析详情
思路与推导
solve1 先为 i 找最小质因子 p 及其最大幂 q,再利用约数和的积性,计算 。
solve2 中,每个正整数 d 是 1 至 n 中恰有 个数的约数,因此累加 等于同一个约数和总和。
n=10 时贡献为 10,10,9,8,10,6,7,8,9,10,和为 87,两行相等,第一行并不更大,判断错误。
第 24 题(判断题,2 分)
当输入为“1000”时,输出的第一行与第二行相等。()
正确答案正确
解析详情
思路与推导
solve1 是逐个数求约数和后累加,solve2 是逐个约数求其出现次数后累加;两者只是交换了求和顺序。
具体恒等式为 ,所以两行相等,判断正确。
这里各项与总和都在相应整数类型的范围内,计算无需依赖浮点近似。
第 25 题(单选题,3 分)
solve1(n) 的时间复杂度为( )。
A.
B.
C.
D.
正确答案D
解析详情
思路与推导
对于质数 p,筛它的各次幂所需枚举次数不超过 。
对所有相关质数累加,得到筛法量级 ;另外生成幂、扫描剩余质数以及最后递推,都不超过这一主项。
因此选 D;即使某个数已被标记,循环仍会访问它,不能把总成本误判为线性。
第 26 题(单选题,3 分)
solve2(n) 的时间复杂度为()。
A.
B.
C.
D.
正确答案B
解析详情
思路与推导
solve2 只有一重循环,i 从 1 增至 n,恰好执行 n 次。
每轮的 n/i、乘法和累加均按常数时间整数运算处理,因此总复杂度为 ,选 B。
第 27 题(单选题,3 分)
输入为 “5” 时,输出的第二行为()。
A.
“20”
B.
“21”
C.
“22”
D.
“23”
正确答案B
解析详情
思路与推导
n=5 时,整数商 n/i 依次为 5、2、1、1、1。
每轮贡献为 1×5=5、2×2=4、3、4、5,累加 ,所以第二行输出 21,选 B。
二、阅读程序(3)
 1 | #include <vector>
 2 | #include <algorithm>
 3 | #include <iostream>
 4 |
 5 | using namespace std;
 6 |
 7 | bool f0(vector<int>& a, int m, int k) {
 8 |     int s = 0;
 9 |     for (int i = 0, j = 0; i < a.size(); i++) {
10 |         while (a[i] - a[j] > m) j++;
11 |         s += i - j;
12 |     }
13 |     return s >= k;
14 | }
15 |
16 | int f(vector<int>& a, int k) {
17 |     sort(a.begin(), a.end());
18 |
19 |     int g = 0;
20 |     int h = a.back() - a[0];
21 |     while (g < h) {
22 |         int m = g + (h - g) / 2;
23 |         if (f0(a, m, k)) {
24 |             h = m;
25 |         } else {
26 |             g = m + 1;
27 |         }
28 |     }
29 |
30 |     return g;
31 | }
32 |
33 | int main() {
34 |     int n, k;
35 |     cin >> n >> k;
36 |     vector<int> a(n, 0);
37 |     for (int i = 0; i < n; i++) {
38 |         cin >> a[i];
39 |     }
40 |     cout << f(a, k) << endl;
41 |     return 0;
42 | }
假设输入总是合法的且 、 和 ,完成下面的判断题和单选题:
第 28 题(判断题,1.5 分)
将第 24 行的 “m” 改为 “m - 1”,输出有可能不变,而剩下情况为少 1。()
正确答案正确
解析详情
思路与推导
设原答案为 v,即计数首次达到 k 的差值阈值。错误修改的是成功分支 h=m−1,不是中点计算公式。
若成功分支遇到 m>v,减 1 后仍有 h≥v;若恰遇到 m=v,才会把 v 排除,使 h=v−1。失败分支只把 g 移到不超过 v 的位置。
因此最终结果只能是 v 或 v−1。例 a=[0,2]、k=1 时仍输出 2;a=[0,1,3]、k=1 时由 1 变为 0,判断正确。
第 29 题(判断题,1.5 分)
将第 22 行的 “ ” 改为 “ ”,输出不变。()
正确答案正确
解析详情
思路与推导
数组元素绝对值至多 ,故最大差值不超过 ;二分始终有 。
所以 h+g 至多 ,在通常 32 位 int 内不会溢出。两式都计算非负区间的向下取整中点,因此输出不变,判断正确。
第 30 题(判断题,1.5 分)
当输入为 “5 7 2 -4 5 1 -3”,输出为 “5”。()
正确答案正确
解析详情
思路与推导
排序后为 [−4,−3,1,2,5]。按每个左端点列差值:从 −4 出发为 1,5,6,9;从 −3 出发为 4,5,8;从 1 出发为 1,4;从 2 出发为 3。
十个差值排序为 1,1,3,4,4,5,5,6,8,9,第 7 小为 5。f 二分的正是第 k 小差值,所以判断正确。
第 31 题(单选题,3 分)
设 a 数组中最大值减小值加 1 为 A,则 f 函数的时间复杂度为( )。
A.
B.
C.
D.
正确答案C
解析详情
思路与推导
先排序需 。二分的整数取值区间含 A 个值,需要 次判定。
f0 中 i、j 都只向右走,各最多移动 n 次,所以一次判定为 ,不是平方级。
总开销为 ,按题目最坏复杂度口径选 C;不能漏掉最开始的排序。
第 32 题(单选题,3 分)
将第 10 行中的 “>” 替换为 “>=”,那么原输出与现输出的大小关系为()。
A.
一定小于
B.
一定小于等于且不一定小于
C.
一定大于等于且不一定大于
D.
以上三种情况都不对
正确答案B
解析详情
思路与推导
按题目的计数意图,原条件把窗口保持为差值≤m,改成 >= 后想保持差值<m。阈值相同而可计入的数对减少,因此若程序安全执行,新二分结果不会更小,给定答案为 B。
但原代码没有限制 j≤i。取 n=2、k=1、a=[0,1],首次 m=0;修改后 i=0 时,a[0]−a[0]=0≥0,使 j 先增至 1,此时连数对计数 i−j 都变成了 −1;到 i=1 时,又因 a[1]−a[1]=0≥0 使 j 增至 2,下一次访问 a[2] 越界。
因此严格按完整 C++ 程序,题设不足以保证一个可比较的新输出。B 描述的是忽略这一缺陷后的单调计数结论,不能当作所有合法输入的运行保证。
第 33 题(单选题,3 分)
当输入为 “5 8 2 -5 3 8 -12” 时,输出为()。
A.
“13”
B.
“14”
C.
“8”
D.
“15”
正确答案B
解析详情
思路与推导
开头 5、8 分别是 n、k,真正的五个元素为 2,−5,3,8,−12,排序得到 [−12,−5,2,3,8]。
按左端点列差值:7,14,15,20;7,8,13;1,6;5。排序为 1,5,6,7,7,8,13,14,15,20。
第 8 小为 14,选 B。不能把 n=5 或 k=8 再当成数组元素加入。
左右滑动表格,可查看完整内容。
| 升序名次 | 绝对差 |
|---|---|
| 1 | 1 |
| 2 | 5 |
| 3 | 6 |
| 4 | 7 |
| 5 | 7 |
| 6 | 8 |
| 7 | 13 |
| 8 | 14 |
| 9 | 15 |
| 10 | 20 |
五个数为 2、−5、3、8、−12;按数对计数,重复差值分别保留。
三、完善程序(1)
(1)(第 k 小路径)给定一张 n 个点 m 条边的有向无环图,顶点编号从 0 到 n-1。对于一条路径,我们定义“路径序列”为该路径从起点出发依次经过的顶点编号构成的序列。求所有至少包含一个点的简单路径中,“路径序列”字典序第 k 小的路径。保证存在至少 k 条路径。上述参数满足 和 。
在程序中,我们求出从每个点出发的路径数量。超过 的数都用 表示。然后我们根据 k 的值和每个顶点的路径数量,确定路径的起点,然后可以类似地依次求出路径中的每个点。
试补全程序。
#include <iostream>
#include <algorithm>
#include <vector>

const int MAXN = 100000;
const long long LIM = 1000000000000000000ll;

int n, m, deg[MAXN];
std::vector<int> E[MAXN];
long long k, f[MAXN];

int next(std::vector<int> cand, long long &k) {
  std::sort(cand.begin(), cand.end());
  for (int u : cand) {
    if (①) return u;
    k -= f[u];
  }
  return -1;
}

int main() {
  std::cin >> n >> m >> k;
  for (int i = 0; i < m; ++i) {
    int u, v;
    std::cin >> u >> v; // 一条从 u 到 v 的边
    E[u].push_back(v);
    ++deg[v];
  }
  std::vector<int> Q;
  for (int i = 0; i < n; ++i)
    if (!deg[i]) Q.push_back(i);
  for (int i = 0; i < n; ++i) {
    int u = Q[i];
    for (int v : E[u]) {
      if (②) Q.push_back(v);
      --deg[v];
    }
  }
  std::reverse(Q.begin(), Q.end());
  for (int u : Q) {
    f[u] = 1;
    for (int v : E[u]) f[u] = ③;
  }
  int u = next(Q, k);
  std::cout << u << std::endl;
  while (④) {
    ⑤;
    u = next(E[u], k);
    std::cout << u << std::endl;
  }
  return 0;
}
第 34 题(单选题,3 分)
①处应填( )
A.
k >= f[u]B.
k <= f[u]C.
k > f[u]D.
k < f[u]正确答案B
解析详情
思路与推导
cand 排序后,每个候选顶点 u 对应一个连续的字典序分组,组内共有 f[u] 条后续路径。
若当前名次 k≤f[u],目标就在这一组,返回 u;若 k>f[u],跳过整组并减去 f[u]。因此①选 B。
这个判断是选择路径分组,并不表示路径会立即在 u 结束;是否结束还要看更新后的 k 是否等于 1。
第 35 题(单选题,3 分)
②处应填()
A.
deg[v] == 1B.
deg[v] == 0C.
deg[v] > 1D.
deg[v] > 0正确答案A
解析详情
思路与推导
deg[v] 是删除当前边之前的剩余入度。当前边是最后一条入边时,deg[v]=1,随后 --deg[v] 才会变成 0。
因此应在 deg[v]==1 时把 v 加入 Q,②选 A;若先判断等于 0,则错过刚好被释放的顶点。
第 36 题(单选题,3 分)
③处应填()
A.
std::min(f[u] + f[v], LIM)B.
std::min(f[u] + f[v] + 1, LIM)C.
std::min(f[u] * f[v], LIM)D.
std::min(f[u] * (f[v] + 1), LIM)正确答案A
解析详情
思路与推导
从 u 出发的路径,要么只包含 u,要么先走到某个后继 v,再接一条从 v 出发的路径。各组按第一步分开,可以相加。
f[u]=1 已经计入单点路径,每条出边只需加 f[v],不能再加 1。由于只查询不超过 LIM 的名次,超过 LIM 的数量统一截断即可。
因此③填 min(f[u]+f[v],LIM),选 A。逆拓扑序保证每个 f[v] 已算好。
第 37 题(单选题,3 分)
④处应填()
A.
u != -1B.
!E[u].empty()C.
k > 0D.
k > 1正确答案D
解析详情
思路与推导
固定当前路径前缀后,立即结束的路径是最短前缀,排在所有继续延长的路径之前,组内名次为 1。
若 k=1,应停止;只有 k>1 时才需要再选择后继,因此④选 D。顶点有出边并不意味着目标路径必须继续走。
第 38 题(单选题,3 分)
⑤处应填()
A.
k += f[u]B.
k -= f[u]C.
--kD.
++k正确答案C
解析详情
思路与推导
进入循环说明目标不是当前就结束的路径。该单条路径恰占一个名次,所以先执行 --k。
随后 next(E[u],k) 才是在各后继路径组中寻找新的第 k 小。若直接减 f[u],会把目标所属的整个大组都跳过,因此⑤选 C。
三、完善程序(2)
(2)(最大值之和)给定整数序列 ,求该序列所有非空连续子序列的最大值之和。上述参数满足 和 。
一个序列的非空连续子序列可以用两个下标 l 和 (其中 )表示,对应的序列为 。两个非空连续子序列不同,当且仅当下标不同。
例如,当原序列为 时,要计算子序列 、 、 、 、 、 、 、 、 、 的最大值之和,答案为 18。注意 和 虽然是原序列的子序列,但不是连续子序列,所以不应该被计算。另外,注意其中有一些值相同的子序列,但由于他们在原序列中的下标不同,属于不同的非空连续子序列,所以会被分别计算。
解决该问题有许多算法,以下程序使用分治算法,时间复杂度 。试补全程序。
#include <iostream>
#include <algorithm>
#include <vector>

const int MAXN = 100000;

int n;
int a[MAXN];
long long ans;

void solve(int l, int r) {
    if (l + 1 == r) {
        ans += a[l];
        return;
    }
    int mid = (l + r) >> 1;
    std::vector<int> pre(a + mid, a + r);
    for (int i = 1; i < r - mid; ++i) ①;
    std::vector<long long> sum(r - mid + 1);
    for (int i = 0; i < r - mid; ++i) sum[i + 1] = sum[i] + pre[i];
    for (int i = mid - 1, j = mid, max = 0; i >= l; --i) {
        while (j < r && ②) ++j;
        max = std::max(max, a[i]);
        ans += ③;
        ans += ④;
    }
    solve(l, mid);
    solve(mid, r);
}

int main() {
    std::cin >> n;
    for (int i = 0; i < n; ++i) std::cin >> a[i];
    ⑤;
    std::cout << ans << std::endl;
    return 0;
}
第 39 题(单选题,3 分)
①处应填()
A.
pre[i] = std::max(pre[i - 1], a[i - 1])B.
pre[i + 1] = std::max(pre[i], pre[i + 1])C.
pre[i] = std::max(pre[i - 1], a[i])D.
pre[i] = std::max(pre[i], pre[i - 1])正确答案D
解析详情
思路与推导
pre 初始复制右半数组 a[mid…r−1]。从左到右处理时,pre[i−1] 已是前 i 项最大值,当前 pre[i] 仍为新元素。
把两者取最大,即 pre[i]=max(pre[i],pre[i−1]),就得到截至当前位置的前缀最大值,①选 D。
例如右半 [2,1,4] 处理成 [2,2,4];pre 的局部下标不能直接当作原数组下标。
第 40 题(单选题,3 分)
②处应填()
A.
a[j] < maxB.
a[j] < a[i]C.
pre[j - mid] < maxD.
pre[j - mid] > max正确答案B
解析详情
思路与推导
循环开始时,j 已是右侧第一个不小于此前左侧最大值的位置。向左加入新元素 a[i] 后,只有当它把左侧最大值提高时,分界才需要继续右移。
若 a[i] 不大于旧 max,a[j]≥旧 max≥a[i],不会移动;若 a[i] 更大,就继续跳过 a[j]<a[i] 的元素,直至遇到新分界。
因此②填 a[j]<a[i],选 B。max 在 while 后才更新,若比较旧 max 会漏掉新元素带来的扩展。
第 41 题(单选题,3 分)
③处应填()
A.
(long long)(j - mid) * maxB.
(long long)(j - mid) * (i - l) * maxC.
sum[j - mid]D.
sum[j - mid] * (i - l)正确答案A
解析详情
思路与推导
对一个固定左端点 i,右端点落在 [mid,j) 时,右侧最大值小于左侧 max,所以这些跨中点区间的最大值都等于 max。
右端点有 j−mid 个,贡献为 (long long)(j−mid)*max,③选 A。
左端点已经由外层循环逐个枚举,不能再乘一次左区间长度;先转 long long 是为了避免乘法溢出。
第 42 题(单选题,3 分)
④处应填()
A.
(long long)(r - j) * maxB.
(long long)(r - j) * (mid - i) * maxC.
sum[r - mid] - sum[j - mid]D.
(sum[r - mid] - sum[j - mid]) * (mid - i)正确答案C
解析详情
思路与推导
右端点位于 [j,r) 时,右侧前缀最大值不小于左侧 max,因此每个区间贡献由 pre 对应位置给出。
sum[t] 保存 pre 前 t 项之和,需要累加 pre[j−mid…r−mid−1],结果是 sum[r−mid]−sum[j−mid],④选 C。
它与③的贡献覆盖所有跨中点区间且互不重叠。
左右滑动表格,可查看完整内容。
| 右端点范围 | 区间最大值由谁决定 | 总贡献 |
|---|---|---|
| [mid, j) | 左侧 max | (j−mid) × max |
| [j, r) | 右侧 pre | sum[r−mid] − sum[j−mid] |
固定左端点 i 后,右端点分成互不重叠的两段;pre 已是右半前缀最大值。
第 43 题(单选题,3 分)
⑤处应填()
A.
solve(0, n)B.
solve(0, n - 1)C.
solve(1, n)D.
solve(1, n - 1)正确答案A
解析详情
思路与推导
solve(l,r) 使用左闭右开区间:l+1==r 表示只有一个元素,两个递归区间为 [l,mid)、[mid,r)。
整个数组的合法下标为 0 至 n−1,应由 [0,n) 覆盖,因此⑤选 solve(0,n),即 A。
分治分别处理左右内部区间,并在当前层处理跨中点区间,每个非空连续子序列恰好被计算一次。