试卷解析 · 理解每一步
洛谷 SCP-S 2022 第一轮模拟赛(提高级 C++)
CSPS-2022-R1-Mock-Luogu
试卷解析总览,可直接查看每题答案与解析。
第 1 题(单选题,2 分)
(1047) = ( )。
A.
(1011011101)
B.
(11010)
C.
(20213)
D.
(308)
正确答案C
解析详情
思路与推导
。而 ,两者相等。
第 2 题(单选题,2 分)
若逻辑变量 A、C 为真,B、D 为假,以下逻辑表达式的值为假的是()。
A.
(B∨C∨D)∨D∧A
B.
((¬A∧B)∨C)∧¬B
C.
(A∧B)∨¬(C∧D∨¬A)
D.
A∧(D∨¬C)∧B
正确答案D
解析详情
思路与推导
代入 、。D 中 ,故 ;其余三个表达式均为真。
第 3 题(单选题,2 分)
小恺编写了如下函数,希望计算斐波那契数列 第 项对 10000 取余数的值:
int f(int x) {
    if (x <= 2)
        return 1;
    int ans = f(x - 1) + f(x - 2);
    ans %= 10000;
    return ans;
}
在运行空间限制 128 MB、栈空间不超过空间限制、运行时限 1 秒的情况下,在主函数中运行 `f(12345)`,最有可能首先发生什么问题?
A.
运行时间超时
B.
栈溢出
C.
访问无效内存
D.
返回错误的答案
正确答案A
解析详情
思路与推导
函数未记忆已算结果,调用次数满足 ,随 指数增长。递归深度只有约 ,通常远未耗尽 128 MB 栈空间时,运行时间就会超过 1 秒。
第 4 题(单选题,2 分)
表达式 的后缀表达式为( )。
A.
-+a/*b-c-cdefB.
abcd-*e/+f-C.
+ab*-cd/e-fD.
f-e/d-d*b+a正确答案B
解析详情
思路与推导
先将 写成 `cd-`,再依次与 相乘、除以 ,得到 `bcd-*e/`;最后执行 和 ,完整后缀式为 `abcd-*e/+f-`。
第 5 题(单选题,2 分)
某个 MV 是一段时长 4 分整的视频文件。它每秒播放 10 帧图像,每帧图像是一幅分辨率为 像素(长宽比 16:9)的 32 位真彩色图像,其画面没有被压缩。其音频的比特率是 128 kbps。这个视频文件大约需要占用多大的存储空间?()。
A.
21 GiB
B.
27 GiB
C.
168 GiB
D.
2 GiB
正确答案A
解析详情
思路与推导
视频共 帧,每帧占 。画面共 ,音频约 ,合计约 21 GiB。
第 6 题(单选题,2 分)
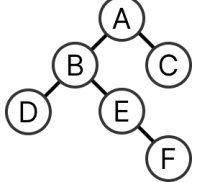
下图是一棵二叉树,它的后序遍历是()。
A.
ABDEFC
B.
DBEFAC
C.
DFEBCA
D.
ABCDEF
正确答案C
解析详情
思路与推导
后序遍历按“左子树、右子树、根”进行。图中 B 子树的顺序为 `DFEB`,随后访问右子树 C,最后访问根 A,因此得到 `DFEBCA`。
第 7 题(单选题,2 分)
五个本质不同的点在没有重边或者自环的情况下,组成不同的无向图的个数是( )?
A.
10
B.
1024
C.
15
D.
120
正确答案B
解析详情
思路与推导
5 个有标号顶点之间共有 对顶点,每一对都可独立选择连边或不连边。因此不同无向图共有 个。
第 8 题(单选题,2 分)
设元素 a, b, c, d, e, f 依次入栈,则下列不合法的出栈序列为()?
A.
d, c, b, e, f, a
B.
f, e, d, c, b, a
C.
c, d, f, e, b, a
D.
e, d, b, a, f, c
正确答案D
解析详情
思路与推导
序列 D 先输出 e、d,此时为得到 e 已将 a 到 e 全部入栈,栈顶依次剩 c、b、a。下一项要求输出 b,但 c 仍压在 b 上方且不能移走后再放回,因此该序列不合法。
第 9 题(单选题,2 分)
同时扔出 k 枚完全相同的六面骰子,每个骰子上有 1 到 6 的数字。将得到的点数排序后,有()种不同的结果?
A.
B.
C.
D.
正确答案D
解析详情
思路与推导
排序后的结果只由点数 1 至 6 各出现多少次决定。设出现次数为 ,则 且 ,由隔板法共有 种。
第 10 题(单选题,2 分)
箱中有 6 个球,编号分别为 1 到 6。从中拿 3 次球,每次拿一个,拿了后放回和不放回时,取出的数字之和的期望分别是():
A.
10.5, 10.5
B.
9, 9
C.
9, 10.5
D.
10.5, 9
正确答案A
解析详情
思路与推导
每次取到的编号期望都为 。无论是否放回,三个位置的边际分布都在 1 至 6 上均匀,故总和期望均为 。
第 11 题(单选题,2 分)
定义 为取模运算,,则 的值为( )。
A.
10081
B.
10085
C.
0
D.
10083
正确答案A
解析详情
思路与推导
,即使从 中除去任一 ,剩余因子仍含足够的 ,所以每个 都是 10086 的倍数。括号内乘积模 10086 为 0,最终余数为 10081。
第 12 题(单选题,2 分)
当 `x = 10` 时,以下代码中 `ans` 的值为( )。
int ans = 0;
void dfs(int x) {
    ++ans;
    if (x <= 1) return;
    dfs(x / 3);
    if (x / 3 + 1 < x) dfs(x / 3 + 1);
    if (x / 3 + 2 < x) dfs(x / 3 + 2);
}A.
24
B.
25
C.
26
D.
27
正确答案C
解析详情
思路与推导
记一次 `dfs(x)` 产生的调用数为 ,则 。可得 、、,所以 ;每次调用使 `ans` 加 1。
第 13 题(单选题,2 分)
最大子段和问题,即给出一个长度为 n 的序列 a,选出其中连续且非空的一段使得这段和最大。当我们采用分治算法去计算这道题的结果时(不可直接动态规划且采用最优的分治方式),最优平均复杂度为()。
A.
B.
C.
D.
正确答案C
解析详情
思路与推导
每个区间同时维护总和、最大前缀和、最大后缀和与最大子段和,左右两半的这些信息可在 时间合并。递推式为 ,解得 。
第 14 题(单选题,2 分)
若某算法的时间计算表示为递推关系式:
则该算法的时间复杂度是()
A.
B.
C.
D.
正确答案C
解析详情
思路与推导
递推中 、,故 。又因非递归部分 比 低一个多项式量级,按主定理有 。
第 15 题(单选题,2 分)
中国计算机协会成立于(___)年。
A.
1961
B.
1962
C.
1971
D.
1972
正确答案B
解析详情
思路与推导
中国计算机学会(CCF,题干写作“中国计算机协会”)成立于 1962 年,因此选择 B。
二、阅读程序(1)
#include <cstdio>
#include <cstring>

const int maxn = 1003;

int type, n, m;
char s[maxn], t[maxn];

int main() {
    scanf("%d %s %s", &type, t, s);
    n = strlen(s); m = strlen(t);
    if (type < 2) {
        for (int i = 0; i < m; ++i) s[i] = t[i];
    } else if (type == 2) {
        strcpy(s, t);
        // 提示:如果此时调用 printf("%s\n", s),则本次输出结果为整个 t 字符串和换行,没有其他字符。
    } else {
        for (int i = 0; i < m; i += 4) {
            unsigned int code = 0, pos = i;
            for (int j = 1; pos < i + 4; j *= 100, ++pos) {
                if (pos == m) break;
                code += t[pos] * j;
            }
            pos = i;
            while (code != 0) {
                s[pos++] = code % 100;
                code /= 100;
            }
        }
    }
    for (int i = 0; i < n; ++i) printf("%c", s[i]);
    printf("\n");
}
第 16 题(判断题,2 分)
将程序中所有的小于号(<)改为不等于号(!=),则程序对所有符合要求的输入的输出结果不变。()
正确答案错误
解析详情
思路与推导
`type < 2` 改成 `type != 2` 后,原本应进入最后一个分支的 `type > 2` 也会进入直接复制分支。例如输入 `3 de fgh` 时执行路径和输出字节都会改变,因此不能保证结果不变。
第 17 题(判断题,2 分)
当输入为1 xyz abcd时,程序的输出为xyzd。()
正确答案正确
解析详情
思路与推导
输入后 `t="xyz"`、`s="abcd"`,所以 。`type=1` 时循环把 `s[0..2]` 改为 `x、y、z`,`s[3]` 仍为 `d`,最终输出 `xyzd`。
第 18 题(判断题,2 分)
程序在输入为1 xyz abcd 时的输出与输入为2 xyz abcd 的输出相同。()
正确答案错误
解析详情
思路与推导
`type=1` 只覆盖前三个字符,输出 `xyzd`;`type=2` 的 `strcpy(s,t)` 还会把 `s[3]` 写成 `\0`。之后虽仍循环输出原来的 个字符,但第四个是空字符,所以两次输出的字节序列不同。
第 19 题(判断题,2 分)
将程序第25~28行的 while 循环替换为 do-while 循环(判断条件和循环体不变),则程序对同一合法输入的输出结果一定不变。()
正确答案正确
解析详情
思路与推导
每组循环至少读入 `t[i]`,合法输入字符的编码非 0,因此进入第 25 行前 `code>0`。原 `while` 本来就必定执行第一次,改成同条件、同循环体的 `do-while` 不会增加迭代次数。
第 20 题(单选题,3 分)
若将程序第 13 行改为 for (int i = 0; i < strlen(t); ++i) s[i] = t[i];,且已知输入的 type 一定为 1 的情况下,用 n 表示 s 的长度,m 表示 t 的长度,则程序的时间复杂度为()。
A.
B.
C.
D.
正确答案B
解析详情
思路与推导
求初始 `strlen(s)` 和最终输出分别为 。修改后的循环每次判断都重新调用 的 `strlen(t)`,共判断 次,复制部分为 ,总复杂度是 。
第 21 题(单选题,3 分)
给程序分别输入选项()的两组输入数据,得到的输出不同。
A.
1 ab abc 和 3 ab abc
B.
1 AB ABC 和 3 AB ABC
C.
1 de fgh 和 3 de fgh
D.
1 DE FGH 和 3 DE FGH
正确答案C
解析详情
思路与推导
`type=3` 用 100 进制打包再拆分;当字符编码均小于 100 时可还原,所以 `ab`、`AB`、`DE` 对应两组输出相同。`d`、`e` 的编码为 100、101,`code=100+10100=10200`,拆出的低位为 `0、2、1`,不再是 `d、e`,故 C 的两组输出不同。
二、阅读程序(2)
#include <iostream>
using namespace std;

const int INF = 1000000000;
#define Front 0
#define Back 1
#define Left 2
#define Right 3
#define Up 4
#define Down 5
int w[6], a[1003][1003];
const int way1[] = {Up, Right, Down, Left};
const int way2[] = {Up, Front, Down, Back};
const int way3[] = {Left, Front, Right, Back};
int get_max(int &a, int b) {
    return a = max(a, b);
}
int right_rotate(int &u) {
    for (int i = 0; i < 4; ++i)
        if (u == way1[i])
            return u = way1[(i + 1) % 4];
    return u;
}
int front_rotate(int &u) {
    for (int i = 0; i < 4; ++i)
        if (u == way2[i])
            return u = way2[(i + 1) % 4];
    return u;
}
const int anchorX = Up;
const int anchorY = Front;
const int anchorZ = Right;
int find_down(int u, int v) {
    if (u == Down || u == Up) return anchorX ^ (u == Up);
    if (v == Down || v == Up) return anchorY ^ (v == Up);
    for (int i = 0; i < 4; ++i)
        if (u == way3[i])
            return anchorZ ^ (v == way3[(i + 1) % 4]);
    return -1;
}
int n, m, dp[1003][1003][6][6];
int main() {
    cin >> n >> m;
    for (int i = 0; i < n; ++i)
        for (int j = 0; j < m; ++j)
            cin >> a[i][j];
    for (int i = 0; i < 6; ++i)
        cin >> w[i];
    for (int i = 0; i < n; ++i)
        for (int j = 0; j < m; ++j)
            for (int a = 0; a < 6; ++a)
                for (int b = 0; b < 6; ++b)
                    dp[i][j][a][b] = -INF;
    dp[0][0][anchorX][anchorY] = a[0][0] * w[Down];
    for (int i = 0; i < n; ++i)
        for (int j = 0; j < m; ++j)
            for (int p = 0; p < 6; ++p)
                for (int q = 0; q < 6; ++q)
                    if (dp[i][j][p][q] != -INF) {
                        int x = dp[i][j][p][q];
                        int u1 = p, v1 = q;
                        right_rotate(u1);
                        right_rotate(v1);
                        get_max(dp[i][j + 1][u1][v1],
                            x + w[find_down(u1, v1)] * a[i][j + 1]);
                        int u2 = p, v2 = q;
                        front_rotate(u2);
                        front_rotate(v2);
                        get_max(dp[i + 1][j][u2][v2],
                            x + w[find_down(u2, v2)] * a[i + 1][j]);
                    }
    int ans = -INF;
    for (int p = 0; p < 6; ++p)
        for (int q = 0; q < 6; ++q)
            ans = max(ans, dp[n - 1][m - 1][p][q]);
    printf("%d\n", ans);
    return 0;
}
第 22 题(判断题,2 分)
存在一种合法的输入数据,使得运行程序时,某次 find_down 函数的返回值是 -1。()
正确答案错误
解析详情
思路与推导
`u` 只能是 0 至 5:若为 `Up/Down`,第一个分支直接返回;否则必为 `Left/Front/Right/Back`,一定能在 `way3` 中找到并返回。因而合法状态下不会走到末尾的 `return -1`。
第 23 题(判断题,2 分)
该程序的时间复杂度为 。()
正确答案错误
解析详情
思路与推导
程序对每个网格位置枚举 `p,q` 各 6 种朝向,共 36 个常数状态;每个有效状态只做向右、向下两次常数转移。初始化与转移的总时间均为 ,不是 。
第 24 题(判断题,2 分)
对于任意 ,「先执行 front_rotate(u),再执行 right_rotate(u)」,与「先执行 right_rotate(u),再执行 front_rotate(u)」,最终 u 的值相同。()
正确答案错误
解析详情
思路与推导
取 `u=Up` 即有反例:先 `front_rotate` 得 `Front`,再右转仍为 `Front`;先 `right_rotate` 得 `Right`,再前转仍为 `Right`。两种结果不同,所以两个旋转操作不可交换。
第 25 题(单选题,3 分)
将 anchorX、anchorY、anchorZ 依次更换为( )时,对于全部合法数据,与改变之前的输出结果无异。
A.
Left、Front、Down
B.
Left、Up、Front
C.
Left、Down、Back
D.
Down、Right、Front
正确答案D
解析详情
思路与推导
原锚点 `Up、Front、Right` 与 D 中的 `Down、Right、Front` 都给出了三个两两垂直且方向一致的基准面;在 `right_rotate/front_rotate` 的所有可达状态间,后者只是对朝向状态作一致重编号。初态由 `find_down` 得到的底面仍为 `Down`,此后每步对应的底面权值也相同,故 DP 最优值不变。
第 26 题(单选题,2 分)
对于以下输入数据,输出结果为( )。
5 5
2 8 15 1 10
5 19 19 3 5
6 6 2 8 2
12 16 3 8 17
12 5 3 14 13
1 1 1 1 1 1A.
95
B.
97
C.
94
D.
103
正确答案B
解析详情
思路与推导
六个权值全为 1,状态朝向不影响得分,问题化为求右下路径最大和。最优移动序列 `RDRRDDRD` 经过数值 ,总和为 。
第 27 题(单选题,2 分)
对于以下输入数据,输出结果为( )。
2 5
2 8 15 3 10
5 19 19 3 5
1 2 3 4 5 6A.
194
B.
157
C.
193
D.
201
正确答案A
解析详情
思路与推导
最优移动序列为 `RDRRR`,各格底面依次为 `Down、Right、Front、Up、Back、Down`。累计得分为 。
二、阅读程序(3)
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 309;
const int MAXM = 109;
const int MAXP = 100000;
typedef long long ll;
int n, m, seed, rt, btm, s[MAXM], Len, dfncnt, full_dist, P, t;
int lg[MAXN], dfn[MAXN], fa[MAXN], dep[MAXN], lson[MAXN];
vector<int> e[MAXN];
vector<int> L[MAXM], leaves;
int F[MAXM];
namespace LCA {
    int st[24][MAXN];
    int minNode(int x, int y) { return dep[x] < dep[y] ? x : y; }
    void init() {
        for (int i = 1; i <= n; ++i) st[0][dfn[i]] = fa[i];
        for (int i = 1; i <= lg[n]; ++i)
            for (int j = 1; j + (1 << i) - 1 <= n; ++j)
                st[i][j] = minNode(st[i - 1][j],
                    st[i - 1][j + (1 << (i - 1))]);
    }
    int lca(int u, int v) {
        if (u == v) return u;
        if ((u = dfn[u]) > (v = dfn[v])) swap(u, v);
        int d = lg[v - u++];
        return minNode(st[d][u], st[d][v - (1 << d) + 1]);
    }
}
namespace Gen {
    mt19937 rnd;
    int pos[MAXN], deg[MAXN];
    vector<pair<int, int>> edges;
    void calc() {
        for (int i = 1; i <= n - 2; ++i)
            ++deg[pos[i]];
        set<int> ret; ret.clear();
        for (int i = 1; i <= n; ++i)
            if (deg[i] == 1) ret.insert(i);
        for (int i = 1; i <= n - 2; ++i) {
            int npos = *ret.begin();
            edges.push_back(make_pair(npos, pos[i]));
            ret.erase(ret.begin());
            --deg[pos[i]];
            if (deg[pos[i]] == 1)
                ret.insert(pos[i]);
        }
        edges.push_back(make_pair(*ret.begin(), n));
    }
    void build() {
        for (auto i : edges) {
            int u = i.first, v = i.second;
            e[u].push_back(v); e[v].push_back(u);
        }
    }
    void generate(int seed) {
        rnd.seed(seed);
        edges.clear();
        for (int i = 1; i <= n; ++i) deg[i] = 1;
        for (int i = 1; i <= n - 2; ++i)
            pos[i] = rnd() % n + 1;
        calc();
        build();
    }
}
int dfs(int u, int _fa, int &bottom) {
    dfn[u] = ++dfncnt;
    if (e[u].size() == 1) leaves.push_back(u);
    lson[u] = -1; fa[u] = _fa; dep[u] = dep[_fa] + 1;
    int maxlen = 0, dson = u, temp;
    for (int v : e[u])
        if (v != _fa) {
            int p = dfs(v, u, temp);
            if (p > maxlen) maxlen = p, lson[u] = v, dson = temp;
        }
    bottom = dson;
    return maxlen + 1;
}
#define dist(u, v) (dep[u] + dep[v] - 2 * dep[LCA::lca(u, v)])
int v[MAXP + 9], prime[MAXP + 9], prime_cnt, vis[MAXP + 9];
void prime_init(int n) {
    prime_cnt = 0;
    for (int i = 2; i <= n; ++i) {
        if (!v[i]) prime[++prime_cnt] = v[i] = i;
        for (int j = 1; j <= prime_cnt && i * prime[j] <= n; ++j) {
            if (v[i] < prime[j]) break;
            v[i * prime[j]] = prime[j];
        }
    }
}
vector<int> answer, gline;
void solve() {
    cin >> n >> m >> seed >> t;
    lg[0] = lg[1] = 0;
    for (int i = 2; i <= n; ++i) lg[i] = lg[i >> 1] + 1;
    for (int i = 1; i <= n; ++i) e[i].clear();
    leaves.clear();
    if (!t) Gen::generate(seed);
    else {
        for (int i = 1, u, v; i < n; ++i) {
            cin >> u >> v;
            e[u].push_back(v); e[v].push_back(u);
        }
    }
    dep[0] = 0; dfs(1, 0, rt);
    dfncnt = 0; leaves.clear();
    Len = dfs(rt, 0, btm); LCA::init();
    for (int k = rt; ~k; k = lson[k]) gline.push_back(k);
    for (int i = 1, tmp; i <= m; ++i) {
        {
            cin >> s[i];
            L[i].clear();
            for (int j = 1; j <= s[i]; ++j) {
                cin >> tmp; L[i].push_back(tmp);
            }
            F[i] = dist(L[i].front(), L[i].back());
            for (unsigned j = 0; j < L[i].size() - 1; ++j)
                F[i] += dist(L[i][j], L[i][j + 1]);
            int tmp = F[i] >> 1;
            while (tmp > 1) vis[v[tmp]] = 1, tmp /= v[tmp];
        }
    }
    full_dist = dist(leaves.front(), leaves.back());
    for (unsigned i = 0; i < leaves.size() - 1; ++i)
        full_dist += dist(leaves[i], leaves[i + 1]);
    P = -100000;
    for (int i = 2; i <= prime_cnt; ++i)
        if (full_dist + 2 * Len < prime[i] * 2 && !vis[prime[i]]) {
            P = prime[i] * 2; break;
        }
    for (int i = 1; i <= m; ++i) {
        F[i] >>= 1;
        while (F[i] > 1) vis[v[F[i]]] = 0, F[i] /= v[F[i]];
    }
    int left = P - full_dist;
    int fcnt = left / (2 * (Len - 1)); answer = leaves;
    while (fcnt--) answer.push_back(rt),
        answer.push_back(btm), left -= 2 * (Len - 1);
    if (left >>= 1) answer.push_back(rt),
        answer.push_back(gline[left]);
    for (int qwq : answer) cout << qwq << " ";
    cout << endl;
}
int main() {
    prime_init(MAXP);
    int T; cin >> T;
    while (T--) solve();
}
第 28 题(判断题,2 分)
调用 LCA::lca() 函数,单次操作的时间复杂度是 。 ()
正确答案错误
解析详情
思路与推导
`lca` 先用 `lg` 取得区间长度对应的幂次,再读取 `st[d][u]` 与 `st[d][v-(1<<d)+1]` 两个预处理结果并比较深度。查询只含常数次数组访问,单次复杂度为 ,不是 。
第 29 题(判断题,2 分)
在 `t = 0` 的情况下,`Len` 的大小在期望下与 同阶。( )
正确答案正确
解析详情
思路与推导
`t=0` 时程序用随机 Prüfer 序列生成均匀随机标号树;两次 `dfs` 找到直径端点,`Len` 正是直径所含结点数。均匀随机标号树的直径期望为 ,故 `Len` 也与 同阶。
第 30 题(判断题,2 分)
`full_dist` 最大不会超过 。( )
正确答案正确
解析详情
思路与推导
`leaves` 按 DFS 次序排列,`full_dist` 累加相邻叶子距离并加上首尾距离,形成一次闭合巡游。树的每条边在这种巡游中至多被经过两次,所以 `full_dist` 不超过 。
第 31 题(单选题,2 分)
对于给定的如下数据,输出结果为( )。
1
5 2 123456 1
1 2
2 3
3 4
4 5
2 1 4
2 3 5A.
2 5 1 5 1 5
B.
4 3 4 3 4 1
C.
5 1 5 1 5 2
D.
4 1 4 1 4 5
正确答案C
解析详情
思路与推导
链 经两次 `dfs` 得 `rt=5、btm=1、Len=5`,叶序列为 `5,1`,故 `full_dist=8`。两条给定序列排除质因子 3 和 2 后选得 `P=22`;补入一次 `5,1`,余量折半为 3,再补 `5,gline[3]=2`,输出 `5 1 5 1 5 2`。
第 32 题(单选题,2 分)
对于给定的如下数据,输出结果为( )。
1
25 4 623532 0
3 11 3 5
5 24 17 15 19 17
6 14 21 16 8 18 21
8 21 18 17 19 24 21 24 17A.
19 24 17 5 17 19 24 4 3 20 11
B.
19 24 17 15 8 16 21 14 19 8 19 13
C.
14 18 21 8 9 21 14 8 15 24 17 19
D.
14 18 21 8 9 21 14 8 22 16 14
正确答案B
解析详情
思路与推导
种子 623532 生成的树经两次 `dfs` 得 `rt=19、btm=8、Len=11`,叶序列为 `19 24 17 15 8 16 21 14`,且 `full_dist=48`。程序选得 `P=74`,先补入 `19,8`,剩余距离折半为 3;`gline[3]=13`,再补 `19,13`,得到选项 B。
第 33 题(单选题,3 分)
答案序列长度的理论上界()?
A.
B.
C.
D.
正确答案D
解析详情
思路与推导
`answer` 初始装入全部叶子,数量至多为 ;随后每次补充往返路径只追加两个端点,追加总数同样受树规模线性约束,故长度上界为 。星形树本身就有 个叶子,使初始答案长度达到 ,所以紧确界为 。
三、完善程序(1)
1. (凑出 17)给定 个互不相同的正整数 ( ),将之排成一行。你需要在每个 前加上一个加号(+)或减号(-),使这 个数字组成一个算式。请问是否存在一种添加符号的方案,使该算式的值为 17?如果存在,请输出 Yes,否则输出 No。
例如,给定 n = 5, , , , , ,则 。
提示:使用穷举法解决这个问题。
试补全程序。
#include <cstdio>

using namespace std;

const int maxn = 25;
const int aim = 17;

int n;
int a[maxn];
bool ans;

int getBit(const int s, int p) {
    return ①;
}

int main() {
    scanf("%d", &n);
    for (②) scanf("%d", a + i);
    for (int s = 0, upperBound = ③; s <= upperBound; ++s) {
        ④;
        for (int j = 0; j < n; ++j) if (getBit(s, j) == 1) {
            sum += a[j];
        } else {
            ⑤;
        }
        if (int(sum) == aim) {
            ans = true;
            break;
        }
    }
    printf("%s\n", ans ? "Yes" : "No");
}
第 34 题(单选题,3 分)
① 处应填()。
A.
(s >> p) & 1B.
(s << p) & 1C.
s & (1 << p) & 1D.
s & (1 >> p) & 1正确答案A
解析详情
思路与推导
要读取整数 `s` 的第 `p` 位,应先右移 `p` 位把目标位移到最低位,再与 1:`(s >> p) & 1`。其结果恰为 0 或 1,可决定给 `a[p]` 添加减号还是加号。
第 35 题(单选题,3 分)
② 处应填( )。
A.
int i = 0; i <= n; ++iB.
int i = 1; i <= n; ++iC.
int i = 0; i < n; ++iD.
int i = 1; i < n; ++i正确答案C
解析详情
思路与推导
后续枚举符号时访问的是 `a[0]` 到 `a[n-1]`,因此读入也必须令 `i` 从 0 开始且满足 `i<n`,即 `int i = 0; i < n; ++i`。
第 36 题(单选题,3 分)
③ 处应填( )。
A.
1 << nB.
(1 << n) | 1C.
(1 << n) + 1D.
(1 << n) - 1正确答案D
解析详情
思路与推导
个数各有正、负两种选择,可由 位二进制状态 至 一一表示。循环条件为 `s <= upperBound`,故上界应填 `(1 << n) - 1`,才能恰好枚举 个状态。
第 37 题(单选题,3 分)
④ 处应填()。
A.
int sum = 0B.
unsigned long long sum = 0C.
unsigned short sum = 0D.
unsigned int sum = 0正确答案B
解析详情
思路与推导
算式绝对值最多为 ,超过 32 位 `int` 和 `unsigned int` 的范围;`unsigned short` 更不足。`unsigned long long` 可容纳枚举过程中加减形成的模 结果,并覆盖所需数值规模。
第 38 题(单选题,3 分)
⑤ 处应填( )。
A.
sum = a[j] + sumB.
sum = a[j] - sumC.
sum = -a[j] + sumD.
sum = -a[j] - sum正确答案C
解析详情
思路与推导
`getBit(s,j)==1` 的分支已经执行 `sum += a[j]`,所以最低位为 0 的另一分支必须减去该数,即 `sum = -a[j] + sum`。这样每个状态才对应一组完整的正负号选择。
三、完善程序(2)
2.(树同构问题)对于两棵有 n 个结点的有根树 和 ,如果存在一个长度为 n 的排列 ,使得对于 中的任意结点对 , 中存在边 当且仅当 中存在边 ,则称 与 同构。现在给出两棵树,求出它们是否同构。
为了解决该问题,有一个算法叫 AHU 算法,其时间复杂度为 ,步骤如下:
考虑将有根树转化为括号序列的递归算法,我们在回溯时会将子树的括号序列依次拼接起来。
如果保证拼接子树括号序列得到的结果与遍历子树的顺序无关,则可保证同构的有根树可以转换为完全一致的括号序列。
● 考虑回溯时将子树括号序列按字典序排序,将以此方式得到的两棵树的括号序列进行比较即可得知两树是否同构。
于是我们得到了一个 时间复杂度的朴素算法,考虑下述优化:
● 考虑朴素算法的复杂度瓶颈,在于括号序列的长度与子树大小相关。
递归时深度为 k 的结点对应的括号序列,可以仅由深度为 的子结点的括号序列得出。
我们考虑对于每个深度 k,将两树中深度为 k 的结点对应的括号序列作为值域进行离散化。
将原先的子结点括号序列的拼接(字符串),用子结点离散化后结果的拼接(整数序列)替代。
这样我们就将与子树大小挂钩的括号序列替换成了与结点度数挂钩的序列,复杂度大大降低。试补全程序。
#include <iostream>
#include <vector>
#include <algorithm>

typedef std::vector<int> Nodes;

struct RootedTree {
    int size, root;
    std::vector<Nodes> edges;
};

RootedTree read() {
    RootedTree res;
    std::cin >> res.size >> res.root;
    res.edges.resize(res.size + 1);

    for (int i = 1; i < res.size; ++i) {
        int u, v;
        std::cin >> u >> v;
        res.edges[u].push_back(v);
        res.edges[v].push_back(u);
    }

    return res;
}

std::vector<Nodes> D; // 某个深度下的所有结点
std::vector<int> fa;

int dfs_depth(const RootedTree &tree, int now, int f, int depth, int nodesDiff) {
    if (①) // 1
        D.push_back(Nodes());

    int nowId = now + nodesDiff;
    D[depth].push_back(nowId);

    if (f != -1)
        fa[nowId] = f + nodesDiff;

    int maxDepth = 0;
    for (int i = 0; i < tree.edges[now].size(); ++i) {
        int child = tree.edges[now][i];
        if (②) { // 2
            maxDepth = std::max(maxDepth,
                dfs_depth(tree, child, now, depth + 1, nodesDiff));
        }
    }
    return maxDepth + 1;
}

typedef std::vector<int> Hash;

std::vector<Hash> hash;

bool cmp(const int x, const int y) {
    return ③; // 3
}

bool check(const RootedTree &t1, const RootedTree &t2) {
    if (t1.size != t2.size)
        return false;
    int size = t1.size;

    D.clear();
    fa.clear();
    fa.resize(size * 2 + 1);

    int dep1 = dfs_depth(t1, t1.root, -1, 0, 0);
    int dep2 = dfs_depth(t2, t2.root, -1, 0, size);
    if (dep1 != dep2)
        return false;

    hash.clear();
    hash.resize(size * 2 + 1);
    std::vector<int> rank(size * 2 + 1);

    for (④) { // 4
        for (int i = 0; i < D[h + 1].size(); ++i) {
            int node = D[h + 1][i];
            hash[fa[node]].push_back(rank[node]);
        }
        std::sort(D[h].begin(), D[h].end(), cmp);
        rank[D[h][0]] = 0;
        for (int i = 1, cnt = 0; i < D[h].size(); ++i) {
            if (⑤) // 5
                ++cnt;
            rank[D[h][i]] = cnt;
        }
    }

    return hash[t1.root] == hash[t2.root + size];
}

int main() {
    RootedTree treeA, treeB;

    treeA = read();
    treeB = read();

    bool isomorphism = check(treeA, treeB);
    std::cout
        << (isomorphism ? "wow!" : "emm...")
        << std::endl;
    return 0;
}
第 39 题(单选题,3 分)
① 对应填()。
A.
D.size() < depthB.
D.size() > depthC.
D.size() != depthD.
D.size() == depth正确答案D
解析详情
思路与推导
DFS 首次到达深度 `depth` 时,已有层数恰为 `D.size()==depth`,此时需 `push_back` 创建 `D[depth]`。再次访问同层结点时 `D.size()>depth`,不应重复创建,因此条件是 `D.size() == depth`。
第 40 题(单选题,3 分)
② 处应填()。
A.
child != f + nodesDiffB.
child != fC.
child + nodesDiff == f + nodesDiffD.
child + nodesDiff != f正确答案B
解析详情
思路与推导
邻接表同时保存父子两个方向的边。遍历 `now` 的邻居时,只有 `child != f` 才是尚需递归的子结点;若递归回父结点,会在树上来回调用而无法终止。
第 41 题(单选题,3 分)
③ 对应填()。
A.
rank[fa[x]] < rank[fa[y]]B.
hash[x].size() < hash[y].size()C.
rank[x] < rank[y]D.
hash[x] < hash[y]正确答案D
解析详情
思路与推导
`hash[x]` 保存结点 `x` 的所有子结点等级序列;AHU 算法需把同深度结点按该序列的字典序排列,再为相同序列赋相同等级。因此比较函数应返回 `hash[x] < hash[y]`。
第 42 题(单选题,3 分)
④ 处应填( )。
A.
int h = dep1 - 1; ~h; --hB.
int h = dep1 - 1; h; --hC.
int h = dep1 - 2; ~h; --hD.
int h = dep1 - 2; h; --h正确答案C
解析详情
思路与推导
树高为 `dep1` 时最深层下标是 `dep1-1`,它没有子结点且等级默认为 0;首次需要处理的是其父层 `dep1-2`。循环必须一直执行到 `h=0`,条件 `~h` 恰在 `h=-1` 时为 0,故填 `int h = dep1 - 2; ~h; --h`。
第 43 题(单选题,3 分)
⑤ 处应填( )。
A.
hash[D[h][i]] != hash[D[h][i - 1]]B.
rank[D[h][i]] != rank[D[h][i - 1]]C.
hash[D[h][i]] < hash[D[h][i - 1]]D.
rank[D[h][i]] < rank[D[h][i - 1]]正确答案A
解析详情
思路与推导
`D[h]` 已按 `hash` 排序,相邻结点的子树编码相同就应得到同一 `rank`;只有 `hash[D[h][i]] != hash[D[h][i-1]]` 时才递增 `cnt`,开始一个新的离散化等级。