试卷解析 · 理解每一步
2024-12-Level-7
2024-12-Level-7
试卷解析总览,可直接查看每题答案与解析。
第 1 题(单选题,2 分)
已知小写字母 b 的 ASCII 码为 98,下列 C++ 代码的输出结果是()。
#include <iostream>
using namespace std;
int main() {
    char a = 'b';
    cout << a + 1;
    return 0;
}A.
b
B.
c
C.
98
D.
99
正确答案D
解析详情
思路与推导
'b' 的 ASCII 码是 98,表达式 a + 1 会先把 char 提升为 int,再做加法得到 99。`cout` 此时输出的是整数 99,不是字符 c。
第 2 题(单选题,2 分)
已知 a 为 int 类型变量,p 为 int * 类型变量,下列赋值语句不符合语法的是()。
A.
+a = *p;
B.
*p = +a;
C.
a = *(p + a);
D.
*(p + a) = a;
正确答案A
解析详情
思路与推导
`+a` 是对变量 `a` 做一元正号运算,结果是一个临时右值,不能出现在赋值号左边。`*p`、`a`、`*(p+a)` 都表示可写入的存储位置,所以其余三项语法合法。
第 3 题(单选题,2 分)
已知数组 a 的定义 int a[10] = {0};,下列说法不正确的是()。
A.
语句 a[-1] = 0; 会产生编译错误。
B.
数组 a 的所有元素均被初始化为 0。
C.
数组 a 至少占用 10 个 int 大小的内存,一般为 40 个字节。
D.
语句 a[13] = 0; 不会产生编译错误,但会导致难以预测的运行结果。
正确答案A
解析详情
思路与推导
`a[-1]` 在语法上能通过编译,它等价于对数组首地址之前的内存做访问,只是运行结果未定义。C++ 默认不检查下标是否落在 `0..9`,所以 A 把“越界”误说成“编译错误”。
第 4 题(单选题,2 分)
下列关于 C++ 类的说法,错误的是()。
A.
构造函数不能声明为虚函数,但析构函数可以。
B.
函数参数如声明为类的引用类型,调用时不会调用该类的复制构造函数。
C.
静态方法属于类、不属于对象,因此不能使用对象.方法(…)的形式调用静态方法。
D.
析构派生类的对象时,一定会调用基类的析构函数。
正确答案C
解析详情
思路与推导
静态方法属于类,但 C++ 语法仍允许用 `对象.静态方法()` 调用,本质上还是按类成员函数处理。A、B、D 都是正确表述,所以错误项是 C。
第 5 题(单选题,2 分)
下列关于有向图的说法,错误的是()。
A.
n个顶点的弱连通有向图,最少有n-1条边。
B.
n个顶点的强连通有向图,最少有n条边。
C.
n个顶点的有向图,最多有条边。
D.
n个顶点的有向完全图,有条边。
正确答案C
解析详情
思路与推导
题目中的“有向图”未限定为简单有向图时,可以允许自环,此时每个顶点都能连向包括自己在内的 `n` 个顶点,最多是 `n^2` 条边。`n(n-1)` 对应的是无自环的有向完全图,所以 C 错、D 对。
第 6 题(单选题,2 分)
一棵二叉树的每个结点均满足:结点的左子树和右子树,要么同时存在,要么同时不存在。该树有197个结点,则其叶结点有多少个?()
A.
98
B.
99
C.
不存在这样的树。
D.
无法确定叶结点数量。
正确答案B
解析详情
思路与推导
每个结点要么有 2 个孩子,要么没有孩子,所以这是典型真二叉树。设内部结点数为 `I`、叶结点数为 `L`,有 `L=I+1`,再由 `L+I=197` 得 `2I+1=197`,所以 `I=98,L=99`。
第 7 题(单选题,2 分)
下列关于二叉树的说法,错误的是()。
A.
二叉排序树的中序遍历顺序与元素排序的顺序是相同的。
B.
n 个元素的二叉排序树,其高一定为。
C.
自平衡二叉查找树(AVL树)是一种二叉排序树。
D.
任意的森林,都可以映射为一颗二叉树进行表达和存储。
正确答案B
解析详情
思路与推导
二叉排序树的高度与插入顺序有关:若按有序序列插入,树会退化成链,高度可达 `n-1`,并不固定是 `⌊log2 n⌋`。只有 AVL、红黑树这类平衡搜索树才把高度控制在对数量级。
第 8 题(单选题,2 分)
一个简单无向图有10个结点、6条边。在最差情况,至少增加多少条边可以使其连通?()
A.
3
B.
4
C.
6
D.
9
正确答案C
解析详情
思路与推导
要让后续补边数最多,就要先让现有 6 条边尽量“浪费”在少数点上。6 条边正好可以构成 4 个点的完全图 `K4`,其余 6 个点都是孤立点,于是共有 7 个连通分量;把 7 个分量连成一个连通图至少还要 `7-1=6` 条边。
第 9 题(单选题,2 分)
一个哈希表,包括n个位置(分别编号0~∼(n-1)),每个位置最多仅能存储一个元素。该哈希表只有插入元素和查询两种操作,没有删除或修改元素的操作。以下说法错误的是()。
A.
如果哈希函数取值范围为0~∼(n-1),且当发生哈希函数碰撞时循环向后寻找空位,则查询操作的最差时间复杂度为O(n)。 (“循环向后”指:0向后一位为1,1向后一位为2,……,(n-2)向后一位为(n-1),(n-1)向后一位为0)
B.
如果哈希函数取值范围为0~∼(n-1),且当发生哈希函数碰撞时仅循环向后一个位置寻找空位,则查询操作的最差时间复杂度为O(1)。
C.
如果哈希函数取值范围为0~∼(m-1)(m<n),且当发生哈希函数碰撞时仅在m~∼(n-1)的范围内寻找空位,则查询操作的最差时间复杂度为O(n-m)。
D.
查询操作时,如果发现查询元素经哈希函数对应的位置为空位,该查询元素仍可能出现在哈希表内。
正确答案D
解析详情
思路与推导
题目明确只有插入和查询,没有删除;开放寻址插入时一旦遇到空位就会停下并存入,因此探查链不会跨过空位。查询某元素时,如果它的哈希起点位置就是空位,就说明这条探查链根本没开始,该元素不可能已经在表中,所以 D 错。
第 10 题(单选题,2 分)
以下关于动态规划的说法中,错误的是()。
A.
动态规划方法将原问题分解为一个或多个相似的子问题。
B.
动态规划方法通常能够列出递推公式。
C.
动态规划方法有递推和递归两种实现形式。
D.
递推实现动态规划方法的时间复杂度总是不低于递归实现。
正确答案D
解析详情
思路与推导
动态规划常见实现有自顶向下记忆化搜索和自底向上递推,两者都可能成立。递推并不一定比递归慢;有时递推少了函数调用开销,有时记忆化只计算被访问到的状态,所以“总是不低于”这个绝对化表述错误。
第 11 题(单选题,2 分)
下面程序的输出为()。
#include <iostream>
#include <cmath>
using namespace std;
int main() {
    cout << (int)exp(2) << endl;
    return 0;
}A.
4
B.
7
C.
100
D.
无法通过编译。
正确答案B
解析详情
思路与推导
`exp(2)` 计算的是 `e^2`,数值约为 `7.389...`,再强制转换成 `int` 时会直接截去小数部分,结果变成 `7`。程序能正常编译,所以输出是 7。
第 12 题(单选题,2 分)
下面程序的输出为()。
#include <iostream>
#define N 10
using namespace std;
int h[N];
int main() {
    h[0] = h[1] = 1;
    for (int n = 2; n < N; n++)
        for (int j = 0; j < n; j++)
            h[n] += h[j] * h[n - j - 1];
        cout << h[6] << endl;
        return 0;
}A.
132
B.
1430
C.
16796
D.
结果是随机的。
正确答案A
解析详情
思路与推导
`h` 是全局数组,未赋值部分会先被初始化为 0。递推式 `h[n] += h[j] * h[n-j-1]` 正是卡特兰数,依次可得 `h2=2,h3=5,h4=14,h5=42,h6=132`,所以输出 132。
第 13 题(单选题,2 分)
上题中程序的时间复杂度为()。
A.
B.
C.
D.
正确答案D
解析详情
思路与推导
外层 `n` 取 `2..N-1`,内层每次执行 `n` 次,因此总次数是 `2+3+...+(N-1)`。这个和约为 `N(N-1)/2`,数量级是 `O(N^2)`。
第 14 题(单选题,2 分)
下面 init_sieve 函数的时间复杂度为()。
int sieve[MAX_N];
void init_sieve(int n) {
    for (int i = 1; i <= n; i++)
        sieve[i] = i;
    for (int i = 2; i <= n; i++)
        for (int j = i; j <= n; j += i)
            sieve[j] --;
}A.
B.
C.
D.
无法正常结束。
正确答案B
解析详情
思路与推导
第一层初始化是 `O(n)`。第二重循环里,固定 `i` 时,`j` 依次取 `i, 2i, 3i...`,大约执行 `n/i` 次,所以总工作量为 `n(1/2+1/3+...+1/n)`,即 `O(n log n)`。
第 15 题(单选题,2 分)
下列选项中,哪个不可能是下图的深度优先遍历序列()。
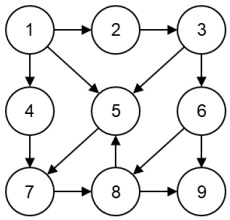
A.
1, 2, 3, 5, 7, 8, 6, 9, 4
B.
1, 4, 7, 8, 9, 5, 2, 3, 6
C.
1, 5, 7, 8, 9, 4, 2, 3, 6
D.
1, 2, 3, 6, 9, 8, 5, 7, 4
正确答案A
解析详情
思路与推导
按 A 的前半段可走出 `1→2→3→5→7→8`。但图中从 8 出发只有到 5、9 的边,5 已访问后若继续 DFS,下一步只能到 9,不可能直接跳到 6;若回溯到 3 再去 6,也必须先把 8 的未访问邻点 9 处理完,所以 A 不可能出现。
判断题
第 1 题(判断题,2 分)
表达式的结果为 125。
正确答案错误
解析详情
思路与推导
在 C++ 里 `^` 表示按位异或,不表示乘方。`5^3` 实际计算的是 `101 XOR 011 = 110`,十进制结果为 6,所以不是 125。
第 2 题(判断题,2 分)
在C++语言中,函数定义和函数调用可以不在同一个文件内。
正确答案正确
解析详情
思路与推导
C++ 支持把函数定义放在另一个源文件中,再通过声明和链接来调用。调用处只要先看到函数声明,链接阶段能找到对应定义即可。
第 3 题(判断题,2 分)
在 n 个元素中进行二分查找,平均时间复杂度是,但须要事先进行排序。
正确答案正确
解析详情
思路与推导
二分查找每比较一次就把待查区间缩小到原来的一半,所以比较次数约为 `log2 n`,平均时间复杂度是 `O(log n)`。但这种“折半”成立的前提是序列已经按关键字排好序。
第 4 题(判断题,2 分)
unsigned long long 类型是C++语言中表达范围最大的非负整数类型之一,其表达范围是。超出该范围的非负整数运算,将无法使用C++语言进行计算。
正确答案错误
解析详情
思路与推导
`unsigned long long` 的常见范围确实是 `[0, 2^64-1]`,但这不代表超出后“无法用 C++ 计算”。可以用高精度整数、数组模拟大数,或在部分编译器下用 `__int128` 继续处理更大的非负整数。
第 5 题(判断题,2 分)
使用 math.h 或 cmath 头文件中的函数,表达式 log2(32) 的结果为 5、类型为 int。
正确答案错误
解析详情
思路与推导
`log2(32)` 的数值结果是 5,但 `math.h/cmath` 中这类函数默认返回浮点类型,通常是 `double`,因此结果类型不是 `int`。题干把“值为 5”和“类型为 int”连在一起,所以整体错误。
第 6 题(判断题,2 分)
C++是一种面向对象编程语言,C则不是。继承是面向对象三大特性之一。因此,使用C语言无法实现继承。
正确答案错误
解析详情
思路与推导
C 语言没有像 C++ 那样的关键字级继承机制,但可以用结构体嵌套、函数指针等方式模拟“基类 + 派生类”效果。题干把“没有原生语法支持”直接推成“完全无法实现”,这个结论过头了。
第 7 题(判断题,2 分)
邻接表和邻接矩阵都是图的存储形式。邻接表在遍历单个顶点的所有边时,时间复杂度更低;邻接矩阵在判断两个顶点之间是否有边时,时间复杂度更低。
正确答案正确
解析详情
思路与推导
邻接表只存实际存在的边,遍历某个顶点的所有出边只需扫它自己的链表,复杂度是 `O(度数)`。邻接矩阵直接查看 `matrix[u][v]` 就能判断两点是否相连,因此查边是 `O(1)`。
第 8 题(判断题,2 分)
MD5 是一种常见的哈希函数,可以由任意长度的数据生成 128 位的哈希值,曾广泛应用于数据完整性校验。中国科学家的系列工作首次发现了可实用的 MD5 破解方法。之后,MD5 逐渐被其他哈希函数所取代。
正确答案正确
解析详情
思路与推导
MD5 的输出长度是 128 位,可处理任意长度输入,早期常用于完整性校验。后来中国科学家王小云团队给出了实用级碰撞攻击,说明它已不适合安全敏感场景,因此逐步被更安全的哈希函数替代。
第 9 题(判断题,2 分)
递归调用在运行时会由于层数过多导致程序崩溃,可以通过循环配合栈缓解这一问题。
正确答案正确
解析详情
思路与推导
递归每深入一层都会占用一层函数调用栈,层数过深时可能触发栈溢出。把递归改成“循环 + 自己维护的栈”后,状态仍能保存,但不再依赖有限的系统调用栈,所以可以缓解这类崩溃。
第 10 题(判断题,2 分)
一个图中,每个顶点表达一个城市,连接两个顶点的边表达从一个城市到达另一个城市的一种交通方式。这个图可以用来表达交通网络,且是简单有向图。
正确答案错误
解析详情
思路与推导
若两个城市之间既有高铁又有航班,就会对应同一对顶点之间的多条有向边;而简单有向图不允许重边。交通网络当然可以用图表示,但更自然的是一般有向图或带重边的图,不一定是简单有向图。