试卷解析 · 理解每一步
2024-06-Level-7
2024-06-Level-7
试卷解析总览,可直接查看每题答案与解析。
第 1 题(单选题,2 分)
下列C++代码的输出结果是()。
#include <iostream>
#include <cmath>
using namespace std;
int main() {
    cout << sin(3.1415926 / 2);
    return 0;
}A.
θ
B.
1
C.
0.5
D.
0.7071
正确答案B
解析详情
思路与推导
程序输出的是 sin(3.1415926 / 2),即接近 sin(π/2)。
sin(π/2)=1,所以输出结果为 1。
第 2 题(单选题,2 分)
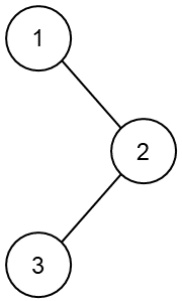
对于如下图的二叉树,说法正确的是()。
A.
先序遍历是 132 。
B.
中序遍历是 123 。
C.
后序遍历是 312 。
D.
先序遍历和后序遍历正好是相反的。
正确答案D
解析详情
思路与推导
图中根结点是 2,左子结点为 1,右子结点为 3。
先序遍历为 213,后序遍历为 132,二者正好互为逆序,因此 D 正确。
第 3 题(单选题,2 分)
已知两个序列s1={1,3,4,5,6,7,7,8,1}、s2={3,5,7,4,8,2,9,5,1},则它们的最长公共子序列是()。
A.
{3,5,7,8,1}
B.
{3,4,5,7,8}
C.
{5,7,8}
D.
{3,5,7,9,1}
正确答案A
解析详情
思路与推导
{3,5,7,8,1} 在 s1 和 s2 中都能按顺序取到,长度为 5。
B 在 s2 中 4 出现在 7 后面,D 含有 9 但 s1 中没有 9,所以 A 才是最长公共子序列。
第 4 题(单选题,2 分)
关于序列 {2,7,1,5,6,4,3,8,9},以下说法错误的是()。
A.
{2,5,6,8,9} 是它的最长上升子序列
B.
{1,5,6,8,9} 是它的最长上升子序列
C.
{7,5,4,3} 是它的最长下降子序列
D.
{1,5,6,8,9} 是它的唯一最长上升子序列
正确答案D
解析详情
思路与推导
这个序列的最长上升子序列长度为 5,{2,5,6,8,9} 和 {1,5,6,8,9} 都满足。
因此“{1,5,6,8,9} 是唯一最长上升子序列”错误,D 为答案。
第 5 题(单选题,2 分)
关于图的深度优先搜索和广度优先搜索,下列说法错误的是()。
A.
二叉树也是一种图。
B.
二叉树的前序遍历和后序遍历都是深度优先搜索的一种。
C.
深度优先搜索可以从任意根节点开始。
D.
二叉树的后序遍历也是广度优先搜索的一种。
正确答案D
解析详情
思路与推导
二叉树的前序、后序遍历都沿着一条分支先走到底,再回溯,本质上属于深度优先。
广度优先对应的是按层访问,二叉树中典型形式是层序遍历,不是后序遍历。
第 6 题(单选题,2 分)
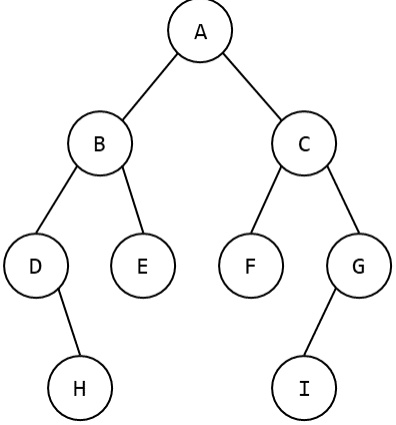
对于如下二叉树,下面访问顺序说法错误的是()。
A.
HDEBFIGCA不是它的后序遍历序列
B.
ABCDEFGHI是它的广度优先遍历序列
C.
ABDHECFGI是它的深度优先遍历序列
D.
ABDHECFGI是它的先序遍历序列
正确答案A
解析详情
思路与推导
该树的后序遍历应为 HDEBFIGCA,所以 A 中“不是它的后序遍历序列”这句话错误。
B 的层序为 ABCDEFGHI,D 的先序为 ABDHECFGI,均与图一致。
第 7 题(单选题,2 分)
以下哪个方案不能合理解决或缓解哈希表冲突()。
A.
丢弃发生冲突的新元素。
B.
在每个哈希表项处,使用不同的哈希函数再建立一个哈希表,管理该表项的冲突元素。
C.
在每个哈希表项处,建立二叉排序树,管理该表项的冲突元素。
D.
使用不同的哈希函数建立额外的哈希表,用来管理所有发生冲突的元素。
正确答案A
解析详情
思路与推导
发生冲突时直接丢弃新元素会造成数据丢失,不能算合理的冲突处理方案。
拉链、在桶内再建树、再做二级哈希都属于可行的缓解思路。
第 8 题(单选题,2 分)
在C++中,关于运算符&,下面说法正确的是()。
A.
2 & 3 的结果是 true
B.
011 & 111 的结果是 3
C.
3 & 6 的结果是 2
D.
110 & 101 的结果是 4
正确答案C
解析详情
思路与推导
在 C++ 中,& 对整数做按位与运算。3 的二进制是 011,6 的二进制是 110,011 & 110 = 010,即 2。
所以正确说法是 C。
第 9 题(单选题,2 分)
下面关于图的说法正确的是()。
A.
在无向图中,环是指至少包含三个不同顶点,并且第一个顶点和最后一个顶点是相同的路径。
B.
在有向图中,环是指一个顶点经过至少另一个顶点到自身的路径。
C.
在有向图中,如果任意两个顶点之间都存在一条边,则这个图一定是强连通图。
D.
在有向图中,所有顶点的入度和出度的总和就是图的边数的两倍。
正确答案D
解析详情
思路与推导
有向图中每条边都会给某个顶点贡献 1 个出度、给某个顶点贡献 1 个入度,所以所有顶点入度和加出度和等于 2 倍边数。
这正是 D 的内容。
第 10 题(单选题,2 分)
图的存储和遍历算法,下面说法错误的是()。
A.
图的深度优先搜索和广度优先搜索对有向图和无向图都适用。
B.
图的深度优先搜索和二叉树的先序遍历道理是不一样的。
C.
图的深度优先搜索需要借助栈来完成。
D.
邻接表中,顶点对应链表中的边结点数目正好是顶点的度。
正确答案B
解析详情
思路与推导
图的深度优先搜索和二叉树先序遍历的核心思想是相近的,都是先沿一条分支尽量深入,再回溯。
因此 B 说“道理是不一样的”错误。
第 11 题(单选题,2 分)
如下图所示的邻接表结构,表示的是下列哪个选项中的图?
θ V1 3 1 ^
1 V2 4 2 θ ^
2 V3 4 3 1 ^
3 V4 2 θ ^
4 V5 2 1 ^A.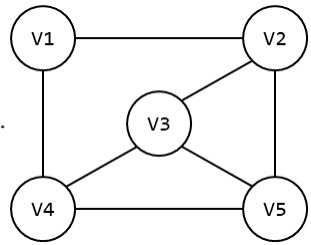
B.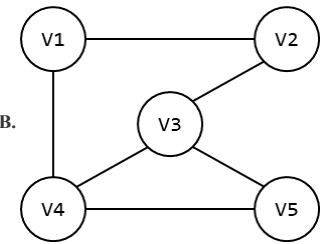
C.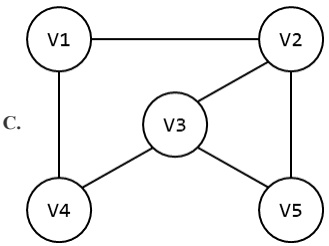
D.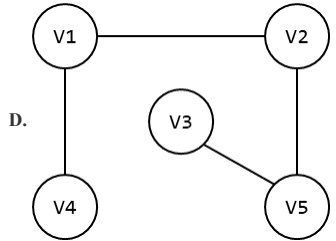
正确答案C
解析详情
思路与推导
由邻接表可读出主要连接关系:V1 连 V2、V4;V3 连 V2、V4、V5;V5 还与 V2 相连。
四个选项中,只有 C 同时满足这些边关系,因此对应图是 C。
第 12 题(单选题,2 分)
如下图所示的邻接矩阵(inf表示无穷大),表示的是下列哪个选项中的图?
    0   1   2   3   4
0 inf inf 12  30  inf
1 inf inf inf inf inf
2 inf inf inf inf 32
3 inf 5   inf inf inf
4 50 inf inf inf infA.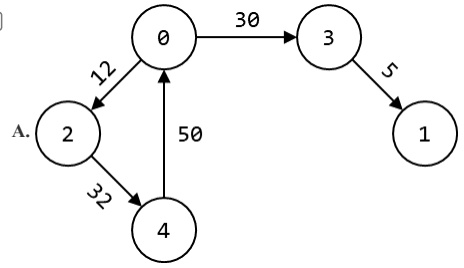
B.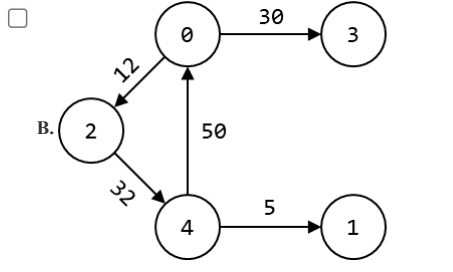
C.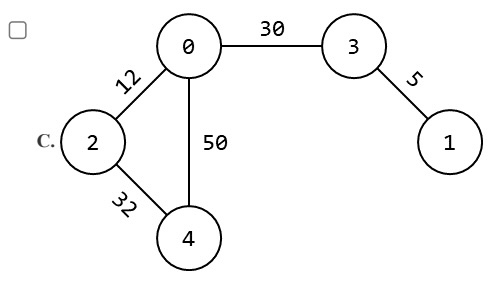
D.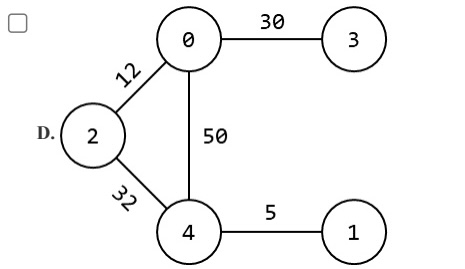
正确答案A
解析详情
思路与推导
矩阵中非 inf 的位置表示有向带权边:0→2 权 12,0→3 权 30,2→4 权 32,3→1 权 5,4→0 权 50。
只有 A 的边方向和权值与这 5 条记录完全一致。
第 13 题(单选题,2 分)
下面程序的输出为()。
#include <iostream>
using namespace std;
int fib(int n) {
    if (n <= 1)
        return n;
    return fib(n - 1) + fib(n - 2);
}
int main() {
    cout << fib(6) << endl;
    return 0;
}A.
5
B.
8
C.
13
D.
无法正常结束。
正确答案B
解析详情
思路与推导
fib(0)=0,fib(1)=1,递推得到 fib(2)=1,fib(3)=2,fib(4)=3,fib(5)=5,fib(6)=8。
因此程序输出 8。
第 14 题(单选题,2 分)
下面 count_triple 函数的时间复杂度为()。
int count_triple(int n) {
    int cnt = 0;
    for (int a = 1; a <= n; a++)
        for (int b = a; a + b <= n; b++) {
            int c = sqrt(a * a + b * b);
            if (a + b + c > n)
                break;
            if (a * a + b * b == c * c)
                cnt++;
        }
    return cnt;
}A.
B.
C.
D.
正确答案B
解析详情
思路与推导
外层 a 最多执行 n 次,内层 b 在每个 a 下最多也是 O(n) 次,所以两层循环总次数是 O(n^2)。
sqrt、比较和加法都可视为 O(1),不会再提高数量级。
第 15 题(单选题,2 分)
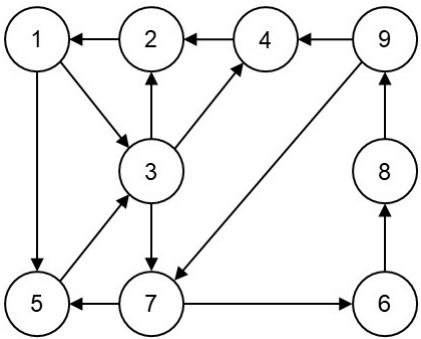
下列选项中,哪个可能是下图的深度优先遍历序列()。
A.
1, 3, 7, 5, 4, 2, 6, 8, 9
B.
9, 4, 2, 1, 3, 5, 7, 6, 8
C.
1, 3, 4, 2, 7, 6, 8, 9, 5
D.
9, 7, 6, 8, 4, 2, 1, 5, 3
正确答案C
解析详情
思路与推导
若从 1 出发,并按图中某种合法邻接顺序做 DFS,可得到 1→3→4→2,回溯后再访问 7→6→8→9,最后到 5。
于是序列 1,3,4,2,7,6,8,9,5 是可能出现的深度优先遍历序列,所以选 C。
判断题
第 1 题(判断题,2 分)
C++语言中,表达式 6 & 5 的结果类型为 int、值为 1。
正确答案错误
解析详情
思路与推导
6 的二进制是 110,5 的二进制是 101,110 & 101 = 100,所以结果值是 4,不是 1。
表达式结果类型仍为 int,但数值判断错了,因此本题错误。
第 2 题(判断题,2 分)
冒泡排序是稳定的排序算法。
正确答案正确
解析详情
思路与推导
冒泡排序只会交换逆序的相邻元素,相等元素的前后次序不会被改变。
因此它属于稳定排序算法。
第 3 题(判断题,2 分)
唯一分解定理(算术基本定理)指出,每个大于1的自然数都可以唯一地分解成若干个素数的乘积。因此,我们可以很容易的对给定的自然数 n 进行质因数分解,时间复杂度仅为。
正确答案错误
解析详情
思路与推导
算术基本定理保证分解结果唯一,但不等于分解过程就能在 O(log n) 内完成。
常见试除法要枚举到 sqrt(n) 量级,远大于 O(log n)。
第 4 题(判断题,2 分)
C++ 语言中,可以为同一个类定义多个构造函数。
正确答案正确
解析详情
思路与推导
C++ 允许同一个类定义多个构造函数,只要它们的参数列表不同即可。
这正是构造函数重载。
第 5 题(判断题,2 分)
使用 math.h 或 cmath 头文件中的对数函数,表达式的结果类型为 double、值约为 7.0。
正确答案错误
解析详情
思路与推导
cmath 中的 log 表示自然对数 ln,log(128)≈4.852,而不是 7.0。
7 对应的是 log2(128),不是默认的 log。
第 6 题(判断题,2 分)
一颗 N 层的二叉树,至少有个节点。
正确答案错误
解析详情
思路与推导
一棵 N 层二叉树要想达到 N 层,最少只需每层放 1 个结点,所以最少结点数是 N。
2^(N-1) 是第 N 层最多可能有的结点数,不是整棵树的最少结点数。
第 7 题(判断题,2 分)
非连通图不能使用广度优先搜索算法进行遍历。
正确答案错误
解析详情
思路与推导
非连通图可以先从一个连通分量做 BFS,完成后再从未访问顶点重新开始。
把各分量都扫完后,整张图仍然可以完成遍历。
第 8 题(判断题,2 分)
现使用有 N 个表项的哈希表,从 M 个元素中进行查找。该哈希表为解决哈希函数冲突,为每个表项处建立单链表存储冲突元素。其查找操作的最坏情况时间复杂度为。
正确答案正确
解析详情
思路与推导
最坏情况下,M 个元素都冲到同一个表项的链表里,查找就要顺着长度为 M 的链逐个比较。
因此最坏时间复杂度是 O(M)。
第 9 题(判断题,2 分)
动态规划有递推实现和递归实现,对于很多问题,通过记录子问题的解,两种实现的时间复杂度是相同的。
正确答案正确
解析详情
思路与推导
记忆化递归和递推表格法如果都把每个子问题只求一次,那么访问的状态数相同,时间复杂度通常一致。
二者主要差别在实现形式和常数开销。
第 10 题(判断题,2 分)
泛洪算法的递归方法容易造成溢出,因此大的二维地图算法中,一般不用递归方法。
正确答案正确
解析详情
思路与推导
递归版泛洪在大地图上可能递归层数过深,导致调用栈溢出。
因此实际处理大规模二维地图时,常改用显式队列或栈的非递归写法。